
ИИ-инструменты помогли собрать исследования и написать первый черновик этой статьи. Я отредактировал текст и сверил каждое исследование, цифру и цитату с оригинальной работой или страницей самой платформы; список — в конце. Обложка создана ИИ. Подробности в конце.
Отсортируйте почти любой рейтинг авторов по столбцу по умолчанию — подписчики, просмотры или вознаграждения — и наверху в основном окажутся те, кто начал раньше. Это не скандал: они дольше работали. Проблема в том, что происходит дальше. Место у вершины приносит внимание, внимание приносит ещё больше считаемого числа, и список начинает описывать собственную историю, а не то, кто делает лучшую работу сейчас.
Программа, которой нужны новые авторы, должна сравнивать людей, пришедших в разное время и с очень разной аудиторией, не превращая рейтинг в награду за стаж. И при этом не должна шарахаться в другую крайность и наказывать за успех.
Это одиннадцатая и последняя часть цикла «Влияние и стимулы» — о том, как другие люди, правила и вознаграждения влияют на то, что мы решаем, пишем и публикуем. В девятой части мы спрашивали, отражает ли размер аудитории авторитет в теме, в десятой — как сделать рейтинг объяснимым. Эта часть посвящена одному узкому вопросу: как честно сравнивать авторов, если у части из них фора.
Почему ранние лидеры продолжают лидировать
Закономерность назвал социолог Роберт К. Мертон в 1968 году. Изучая, как учёные получают признание, он описал «эффект Матфея» — по евангельскому стиху о том, что имеющему дастся, — как «накопление всё больших приращений признания за отдельные научные работы у учёных с громкой репутацией и отказ в таком признании учёным, которые ещё не заявили о себе» [1]. Он также отметил, что именитые учёные знали об этом и прилагали особые усилия, чтобы ему противодействовать [1].
Два более поздних эксперимента показывают механизм напрямую.
В 2006 году Мэтью Салганик, Питер Шеридан Доддс и Дункан Уоттс создали онлайн-«музыкальный рынок», где 14 341 участник слушал и скачивал песни неизвестных групп [2]. Одни участники видели только список песен, другие — ещё и число скачиваний каждой. Показ этих чисел изменил исход: «Усиление социального влияния увеличило и неравенство, и непредсказуемость успеха» [2]. Качество всё же играло роль, но лишь отчасти: «Лучшие песни редко проваливались, а худшие редко добивались успеха, но любой другой исход был возможен» [2].
В 2014 году Арнаут ван де Рейт с коллегами пошли дальше и вмешались в работу живых систем: они давали первое пожертвование случайно выбранным проектам на Kickstarter, положительные оценки на Epinions, награды редакторам Wikipedia и подписи петициям на Change.org [3]. В каждой системе «ранний успех, дарованный произвольно выбранным получателям, дал значимое улучшение последующих показателей успеха по сравнению с контрольной группой не получавших» [3]. На Kickstarter одно начальное пожертвование делало проект примерно вдвое более вероятным кандидатом на финансирование [3]. Авторы сообщают, что произвольный разрыв между выбранными и невыбранными сохранялся в каждом исследовании, хотя в некоторых системах сокращался и к концу становился небольшим [3].
В той же работе нашёлся предел, важный для устройства программ. Успех «демонстрировал убывающую отдачу: большие начальные преимущества не давали заметной дальнейшей дифференциации» [3]; по словам авторов, «подкрепляющая ценность одного начального успеха намного больше, чем у дополнительных успехов» [3]. Первый толчок многое меняет. Десятый — почти ничего.
Для рейтинга авторов вывод неприятный, но полезный: таблица лидеров не только измеряет, но и раздаёт внимание. Тот, кто наверху, остаётся там отчасти потому, что он наверху.
Три преимущества, которые прячет итог
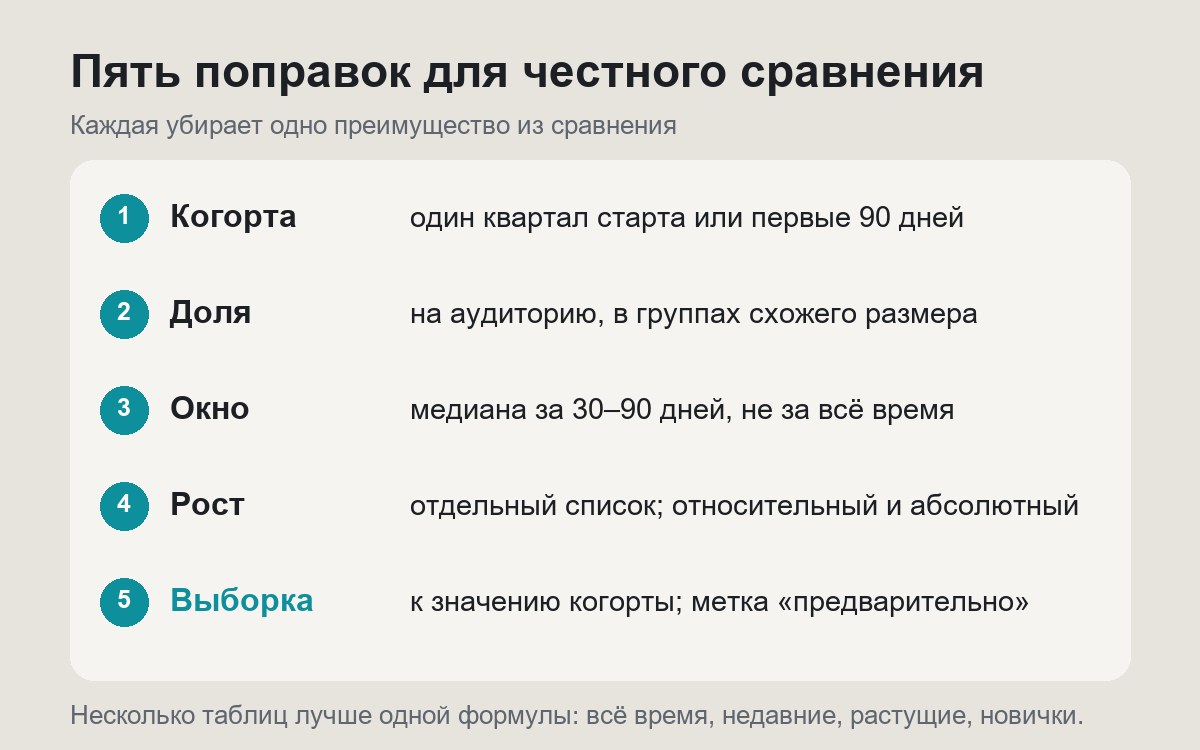
Накопленный итог смешивает нынешнюю работу автора с тремя преимуществами, мало с ней связанными.
Время. Автор, который публикуется четыре года, четыре года копил просмотры, подписчиков и вознаграждения. Новичок на третьем месяце не догонит его по накопленному счёту, как бы хороша ни была его работа.
Аудитория. Каждый новый пост крупного аккаунта стартует с большой аудиторией. Одна и та же статья, опубликованная автором со 100 000 подписчиков и автором с 2000, в первый день наберёт очень разные итоги по причинам, не связанным с текстом.
Видимость. Ранжированные списки, страницы «лучшие авторы» и места в рекомендациях направляют дополнительных читателей тем, кто и так наверху. Это тот самый контур из экспериментов выше: считаемое число питает само себя.
Ничто из этого само по себе не несправедливо. Время и аудитория обычно заработаны. Они просто отвечают на другой вопрос, чем «кто сейчас делает сильную работу?». Честное сравнение разделяет вопросы, а не делает вид, что одно число отвечает на оба.
Пять поправок, делающих сравнение честнее
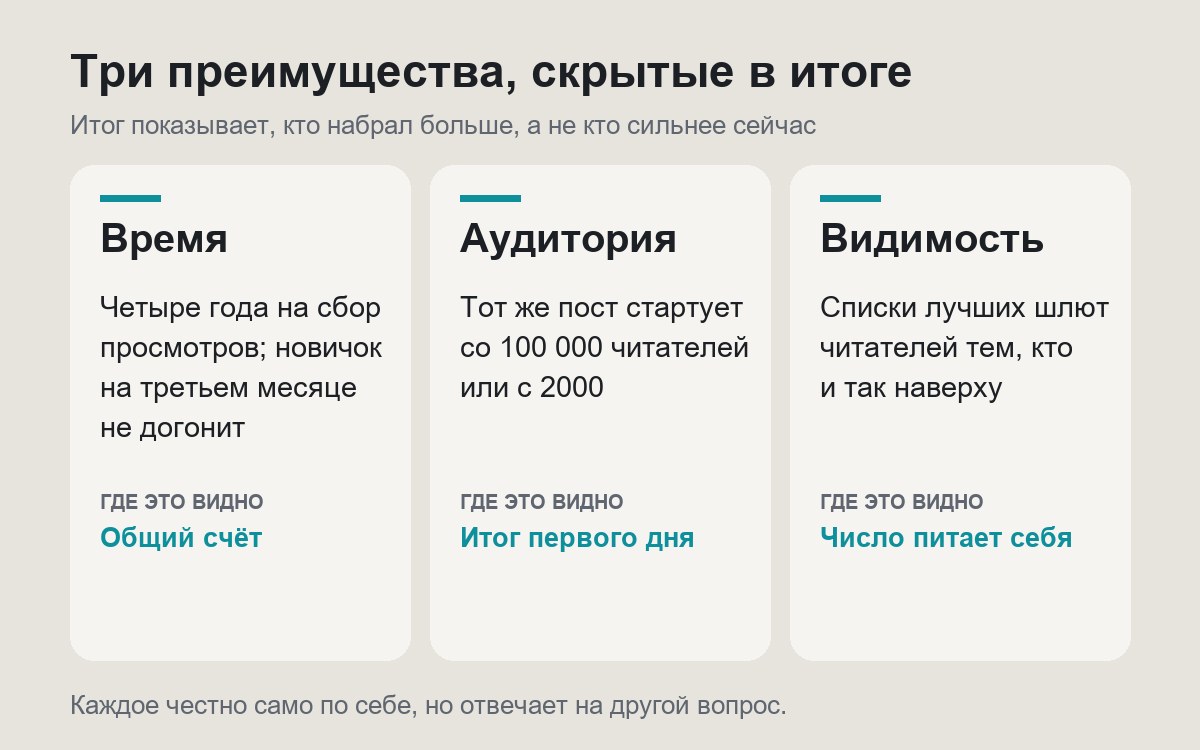
Каждая поправка убирает из сравнения одно преимущество. Универсальной формулы нет; настройки зависят от платформы и размера программы.
1. Сравнивайте авторов одного возраста
Разбейте авторов на когорты по месяцу или кварталу старта и сравнивайте каждого с его когортой. Полезный вариант — сравнивать всех в одном «возрасте» на платформе: чего каждый добился за первые 90 дней? Весенний новичок тогда измеряется тем, что сделали состоявшиеся авторы в свои первые 90 дней, а не их четырёхлетними итогами.
Исследовательские заметки, на которых основана статья, рекомендуют то же для небольшой программы: делить авторов по когортам и сравнивать до и после изменения, а не подгонять статистическую модель под несколько десятков человек.
2. Берите доли и сравнивайте внутри групп по размеру
Делите на ту аудиторию, которая у автора реально есть: ответы на пост, прочтения на подписчика, вернувшиеся читатели на сто визитов. Это снимает большую часть преимущества аудитории.
У долей есть собственный перекос. Заметки, на которых основана статья, ожидают, что у малых аккаунтов вовлечённость выше, чем у крупных; если на конкретной платформе это так, чистая доля на подписчика сдвигает преимущество к самым маленьким. Проверьте это на своих данных, прежде чем полагаться на неё. Два практических решения: сравнивать доли только внутри групп схожего размера или переводить каждое число в перцентиль внутри группы и платформы, так что сопоставимой единицей становится «верхние 10% среди аккаунтов такого размера на этой платформе». Заметки также предлагают смягчить знаменатель: делить не на число подписчиков, а на его меньшую степень, — но точная степень задаётся калибровкой, а не известной константой.
3. Смотрите на недавние окна, а не на всё время
Медиана за последние 30 или 90 дней описывает то, что автор делает сейчас. Она же даёт вернувшемуся или растущему автору честный шанс подняться и не позволяет знаменитому старому посту годами тянуть кого-то наверх. Итог за всё время может оставаться в профиле как история; он просто не должен решать сравнение этого месяца.
4. Измеряйте рост, но взвешивайте разумно
Отдельный список тех, кто растёт быстрее всех, — один из самых прямых способов показать новичков. Substack делает это открыто: рядом с видом «Top Bestseller», упорядоченным по годовой повторяющейся выручке, его вид «Rising» «выделяет самые быстрорастущие издания в категории по приросту платных подписок» [6]. Точную формулу Substack не публиковал.
У роста нужна одна защита. В процентах он вознаграждает самые крошечные аккаунты: переход от 100 к 200 подписчикам — это рост на 100%. Заметки предлагают сочетать относительный рост с абсолютным, чтобы скачок с 1000 до 2000 не обгонял автоматически скачок со 100 000 до 120 000. Они также указывают на практический холодный старт: в день запуска истории нет, поэтому рост можно включать лишь после первого месяца снимков.
5. Будьте честны с малыми выборками
У нового автора с тремя постами среднее очень неопределённо. Один удачный пост может поставить его первым, одна тихая неделя — последним. Статистики давно с этим работают. Известное руководство Эвана Миллера по сортировке оценок утверждает, что оценка должна «уравновешивать долю положительных оценок и неопределённость малого числа наблюдений», и рекомендует нижнюю границу интервала Уилсона [5].
У этого метода есть побочный эффект, о котором стоит знать: поскольку нижняя граница осторожна, объекты с малым числом наблюдений тонут. В одном общем списке он незаметно хоронит всех новичков. Для сравнения авторов лучше два варианта:
- Подтягивайте малые выборки к типичному значению когорты, а не к нулю, чтобы новый автор начинал с середины и двигался по мере появления данных.
- Показывайте неопределённость, а не прячьте её. Помечайте авторов с малой историей как «новых» или «предварительных» и ранжируйте их в отдельной таблице, пока у них не наберётся достаточно постов.
Несколько таблиц вместо одной формулы
Единый рейтинг, который пытается быть честным ко всем, вынужден прятать компромиссы в весах. Отдельные списки делают компромиссы видимыми: таблица за всё время для накопленной работы, недавняя таблица за последние 90 дней, таблица роста и таблица новых авторов по когортам. Каждая отвечает на один ясный вопрос, и читатель видит, на какую смотрит. Отдельные таблицы также распределяют внимание, которое приносит верхнее место, между несколькими группами авторов, а не концентрируют его на одной.
Небольшой первый толчок даёт многое
Выводы ван де Рейта подсказывают, где самая дешёвая помощь. Если первый успех значит намного больше последующих [3], программе не нужны крупные подпорки для новичков. Основную работу делает небольшая регулярная доля видимых мест на страницах рекомендаций, в рассылках или на главной, зарезервированная для недавних авторов и ротируемая так, чтобы многие из них получили один честный просмотр. Дальше решают читатели.
Та же логика против того, чтобы сыпать новые награды тем, кто и так наверху. Правило неравенства участия Якоба Нильсена, впервые опубликованное в 2006 году, описывает сообщества, где примерно 90% людей только читают, 9% время от времени вносят вклад, а «1% пользователей участвует активно и даёт большую часть вклада» [4]. Среди его рекомендаций есть строка, которую могла бы принять любая программа для авторов: «Вознаграждайте участников, но не вознаграждайте чрезмерно» [4]. Отсюда простая проверка: отслеживайте, какая доля всех вознаграждений уходит верхней десятой части авторов каждый месяц, и считайте устойчивый рост вопросом к устройству программы.
Что могут сломать поправки
Каждая поправка переносит преимущество в другое место, а там его можно накрутить.
- Доли поощряют маленькие закрытые круги. Крошечный аккаунт с преданной группой друзей может показывать отличную долю на подписчика. Для сравнений по долям нужны те же проверки на повторяющиеся группы, что описаны в восьмой части.
- Места для новичков привлекают свежие аккаунты. Если быть новичком выгодно, кто-то будет начинать заново. Привязывайте статус новичка к подтверждённой личности или платёжному аккаунту, а не к новому профилю.
- Честность — не то же, что равный результат. Эксперимент с музыкой показал, что лучшие песни редко проваливались [2]. Часть лидеров впереди, потому что их работа лучше. Цель — не дать рейтингу добавлять лишнее преимущество, а не тянуть лидеров вниз.
Разобранный пример (вымышленный)
Программа, авторы и все цифры ниже выдуманы, чтобы показать поправки в действии.
Издание ранжирует авторов по общему числу прочтений и платит ежемесячный бонус пятёрке лучших. Три автора стоят на очень разных местах списка.
Автор A начал четыре года назад, у него 40 000 подписчиков и лидерство с 1,2 млн прочтений за всё время. За последние 90 дней медианную статью A прочитали около 2% подписчиков.
Автор B начал восемь месяцев назад, у него 3000 подписчиков и 61-е место. Медианную статью B за последние 90 дней прочитали 9% подписчиков. По сравнению с другими авторами с 1000–5000 подписчиков это верхняя десятая часть. За свои первые 90 дней B привлёк больше вернувшихся читателей, чем A за свои первые 90 дней.
Автор C пришёл три недели назад с двумя статьями, одна из которых прошла очень хорошо. В списке по среднему на статью C — первый.
Таблица за всё время говорит: A, а затем большой разрыв. Скорректированные виды говорят больше: A — сильный состоявшийся автор; B — сильнейший среди когорт года; у C слишком мало истории для ранжирования. Честная программа сохранила бы за A место в таблице за всё время, поставила бы B наверх недавней таблицы и таблицы роста, дала бы C место на странице новичков с пометкой «предварительно» и выплачивала бы часть бонусного фонда по каждой таблице, а не весь по прочтениям за всё время.
Пять вопросов перед ранжированием авторов
- На какой вопрос отвечает каждая таблица? Накопленная работа, недавняя работа, рост и новички — разные вопросы.
- Кто когда начал? Сравнивайте авторов с их когортой или в одном возрасте на платформе.
- Что в знаменателе? Делите на аудиторию и сравнивайте внутри групп по размеру.
- Сколько наблюдений у каждого автора? Помечайте и выделяйте авторов с малой историей.
- Куда уходит внимание? Проверяйте, какую долю видимых мест и вознаграждений каждый месяц получает верхняя десятая часть.
О чём эта статья не может сказать
Приведённые эксперименты измеряли песни, краудфандинг, оценки, награды редакторам и петиции, а не программы для авторов; они показывают, что раннее преимущество питает само себя, но не то, насколько сильно это происходит на конкретной платформе. Вид Rising у Substack описан по их собственному анонсу; формула не публична. Поправки — стандартные приёмы сравнения, адаптированные из исследовательских заметок, на которых основана статья, и каждое число в заметках, такое как степени сглаживания или веса роста, — оценка для калибровки, а не проверенное значение. Ничто здесь не оценивает реального автора или какую-либо программу на Dapp.Expert. Отражает ли размер аудитории авторитет в теме и как объяснять рейтинг тем, кто в нём участвует, разобрано в двух предыдущих частях.
Как сделана эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверено |
|---|---|---|---|
| Исследование | Собрал в исследовательские заметки работы, примеры платформ и методы сравнения | Выбрал вопрос и источники, на которые опираться | Исследования, цифры и цитаты сверены с работами и страницами платформ [1]–[6] |
| Черновик | Написал первый черновик по заметкам | Отредактировал текст, структуру и разобранный пример | Отдельное ревью сверило цифры и утверждения с источниками |
| Изображения | Создал обложку в стиле фотографии; построил схемы по шаблону из кода | Выбрал иллюстрацию и содержание схем | Помечены как созданные ИИ в строке раскрытия и в alt-тексте |
| Не делал ИИ | — | Решение о публикации и ответственность за текст | — |
Конфликт интересов: нет. У автора нет коммерческих отношений с названными платформами, исследователями и изданиями; программа и авторы в примере вымышлены.
Ответственный за статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Метки: official (собственный анонс или страница платформы), paper (научная работа, прочитанная в оригинале или по официальной записи), guide (опубликованное объяснение практика).
- Robert K. Merton, "The Matthew Effect in Science", Science 159(3810), 56–63, 5 January 1968. https://doi.org/10.1126/science.159.3810.56 Paper.
- Matthew J. Salganik, Peter Sheridan Dodds, Duncan J. Watts, "Experimental Study of Inequality and Unpredictability in an Artificial Cultural Market", Science 311, 854–856, 2006. https://doi.org/10.1126/science.1121066 Paper.
- Arnout van de Rijt, Soong Moon Kang, Michael Restivo, Akshay Patil, "Field experiments of success-breeds-success dynamics", PNAS 111(19), 6934–6939, 2014. https://pmc.ncbi.nlm.nih.gov/articles/PMC4024896/ Paper.
- Jakob Nielsen, "Participation Inequality: The 90-9-1 Rule for Social Features", Nielsen Norman Group, 8 October 2006. https://www.nngroup.com/articles/participation-inequality/ Guide.
- Evan Miller, "How Not To Sort By Average Rating", 6 February 2009. https://www.evanmiller.org/how-not-to-sort-by-average-rating.html Guide.
- Substack, "A new view for leaderboards", On Substack, 27 March 2025. https://on.substack.com/p/a-new-view-for-leaderboards Official.











