
ИИ-инструменты помогли собрать исследование и написать первый черновик этой статьи. Я отредактировал текст и сверил каждую цифру и цитату со страницей-источником из списка в конце. Обложка создана ИИ. Подробности в конце статьи.
Интересующий вас запрос вдруг идёт вверх в Google Trends. Тема появляется в списке трендов. Новый open-source-проект за неделю набирает тысячи звёзд. Соблазн велик: увидеть в этом начало чего-то большого и написать об этом первым.
Иногда так и есть. Но нередко линия падает так же быстро, как росла, и статья выходит, когда интерес уже ушёл. Разницу между трендом и всплеском не видно на одном графике за один день. Она проявляется в том, что на самом деле измеряет число, держится ли оно и движутся ли вместе с ним другие, независимые сигналы.
Это первая часть новой серии «Радар интересов»: как находить вопросы, которые стоит исследовать, раньше, чем на них начнут отвечать все. Начинаем с самой базовой проблемы: отличить устойчивый рост интереса от короткого всплеска шума.
Что на самом деле считает инструмент трендов
Большинство читают график Google Trends как число поисковых запросов. Это не так, и для ранних сигналов разница важна.
Согласно справке самого Google, Trends строится на «в основном нефильтрованной выборке реальных поисковых запросов, сделанных в Google» [1]. Каждая точка делится на общее число запросов в том же месте и за тот же период, затем масштабируется от 0 до 100 по доле темы во всех запросах [1]. То есть график показывает долю внимания, а не число людей, и шкала пересчитывается при каждом сравнении.
Три детали с той же страницы особенно важны, когда тема новая:
- Малый объём показывается как ноль. Trends показывает данные только по достаточно популярным запросам; редкие запросы отображаются как 0, и Google отмечает, что ноль не значит, что никто не искал [1]. Узкий технический термин может по-настоящему расти и всё равно выглядеть ровной линией.
- Шум добавляется намеренно. Чтобы защитить приватность, Google добавляет статистический шум, наиболее заметный у запросов с низким интересом. В справке предупреждают, что единичный всплеск может оказаться случайным колебанием, и советуют сравнивать с распространёнными запросами, чтобы оценить масштаб [1].
- Часы меняются вместе с окном. Для периодов от 30 дней графики в Explore используют UTC; для семи дней и меньше — местное время вашего браузера [1]. «Всплески» по часам в коротком окне и дневные точки в длинном напрямую не сопоставимы.
У панели «Похожие запросы» своя ловушка. «Растущие» запросы ранжируются по приросту относительно предыдущего периода, а метка «Прорыв» (Breakout) заменяет процент, когда запрос вырос больше чем на 5000% [2]. Прорыв говорит, что запрос быстро вырос от того, с чего начинал. Он не говорит, что исходная точка была большой. Запрос, который от почти нуля дорос до «немного», — тоже прорыв.
Всё это не делает инструмент бесполезным. Это инструмент для сравнения долей во времени, а не счётчик спроса.
Что поисковые данные могут и не могут предсказать
Самый известный положительный результат при внимательном чтении оказывается скромным. В рабочей статье Google 2009 года, позже опубликованной в Economic Record, Хёнён Чхве и Хэл Вэриан проверили, улучшают ли данные Trends простые модели официальной статистики: продаж в рознице, автомобилей и жилья, прибытия посетителей [3]. Они прямо обозначили границу: «Мы не утверждаем, что данные Google Trends помогают предсказывать будущее» [3]. Утверждалось другое: поисковые данные помогают оценить настоящее до публикации официальной цифры. В примере с продажами автомобилей средняя абсолютная ошибка модели с поисковым индексом была примерно на 3% меньше, чем у модели без него; в других примерах статьи выигрыш был больше, около 12–18% [3]. Полезно, но не хрустальный шар.
Самый известный провал показывает, что бывает, если поисковый сигнал принимают за большее. Google Flu Trends создавали, чтобы оценивать число визитов к врачам с гриппоподобными симптомами раньше отчётов американских Центров по контролю и профилактике заболеваний (CDC). В статье 2014 года в Science Дэвид Лазер с коллегами отметили, что в феврале 2013 года система предсказывала более чем вдвое больше, чем показывали данные CDC, и что она завышала оценку в 100 из 108 недель, начиная с августа 2011 года [4]. Исходный метод, писали они, искал лучшие совпадения среди 50 миллионов поисковых терминов, чтобы подогнать 1152 точки данных [4]. При таком числе кандидатов часть терминов совпадёт с гриппозным сезоном случайно. Основную ошибку они назвали «высокомерием больших данных»: большие данные принимают за замену традиционного сбора данных, а не за дополнение к нему [4].
Два урока пригодятся всем, кто следит за темами:
- Поисковый сигнал сильнее всего как описание текущего внимания. Читать его как прогноз — отдельное утверждение, и ему нужны собственные доказательства.
- Если просматривать много терминов в поисках растущих, какие-то будут расти случайно. Чем шире просмотр, тем важнее независимая проверка.
В исследованиях, на которых построена эта серия, не нашлось независимой работы, которая измеряла бы, насколько раньше широкого интереса движется любой публичный сигнал: поиск, активность разработчиков или соцсети. Цифры упреждения, которые приводят вендоры и практики, независимо не проверялись. Поэтому эта статья не предлагает волшебного раннего индикатора. Она предлагает способы не попасться на всплеск.
Почему многие всплески — шум или покупка
Всплеск не всегда естественный. Ряд исследований показывает, что видимые признаки «это набирает ход» можно создать намеренно.
Списки трендов. Тугрулджан Эльмас с коллегами описал то, что назвал эфемерным астротурфингом в Twitter: скоординированная активность фальшивых и взломанных аккаунтов выводит выбранное слово в список трендов, а затем эта активность удаляется как часть атаки [5]. В их работе, принятой на IEEE Euro S&P 2021, тренды, накрученные таким образом, составляли не менее 20% первой десятки мировых трендов [5]. Речь о Twitter несколько лет назад, и в сегодняшнем X доля может быть иной. Суть в том, что метка «в тренде» сама по себе — слабое доказательство.
Популярность среди разработчиков. Хао Хэ с коллегами создал инструмент для поиска подозрительной активности со звёздами в метаданных GitHub за 2019–2024 годы. В их препринте «Шесть миллионов (предположительно) фальшивых звёзд на GitHub» сообщается, что в 2024 году активность с фальшивыми звёздами резко выросла, что у них «есть эффект продвижения только в краткосрочной перспективе (менее двух месяцев)», а в долгосрочной они становятся обузой [6]. То есть купленный всплеск может несколько недель выглядеть точно как настоящий, а потом прекращаться. Следующие статьи серии подробнее рассматривают сигналы от разработчиков.
Изменения в способе получения данных. Иногда линия движется потому, что поменялись правила. С 1 октября 2026 года arXiv ограничивает каждого автора двумя отправками в календарный месяц как временную меру после рекордного объёма: 40 363 отправки в сентябре 2026 года против 20 569 в сентябре 2024 года [7]. Тот, кто считает новые статьи по теме, увидит в октябре падение, которое ничего не говорит об интересе к теме. Сравнение доли темы во всех работах вместо абсолютных чисел уменьшает эту проблему, а дату перелома стоит записать.
Недолговечные форматы. В социальном видео быстрое затухание — норма. Исследование Publicis Groupe APAC по семи рынкам, о котором сообщает Marketing-Interactive, показало: почти половина трендов TikTok исчезает в течение пяти дней, и лишь малая часть остаётся актуальной дольше двух недель [8]. Это исследование агентства, в той же статье его хвалит TikTok, выборка не раскрыта, так что цифры считайте ориентировочными. Всё же они говорят: неделя — короткий срок для соцсетевой ленты и долгий для трендового звука.
Тренд или всплеск: как выглядит каждый
Если свести доказательства вместе, заметны несколько практических различий. Ни одно не доказывает само по себе; это поводы присмотреться.
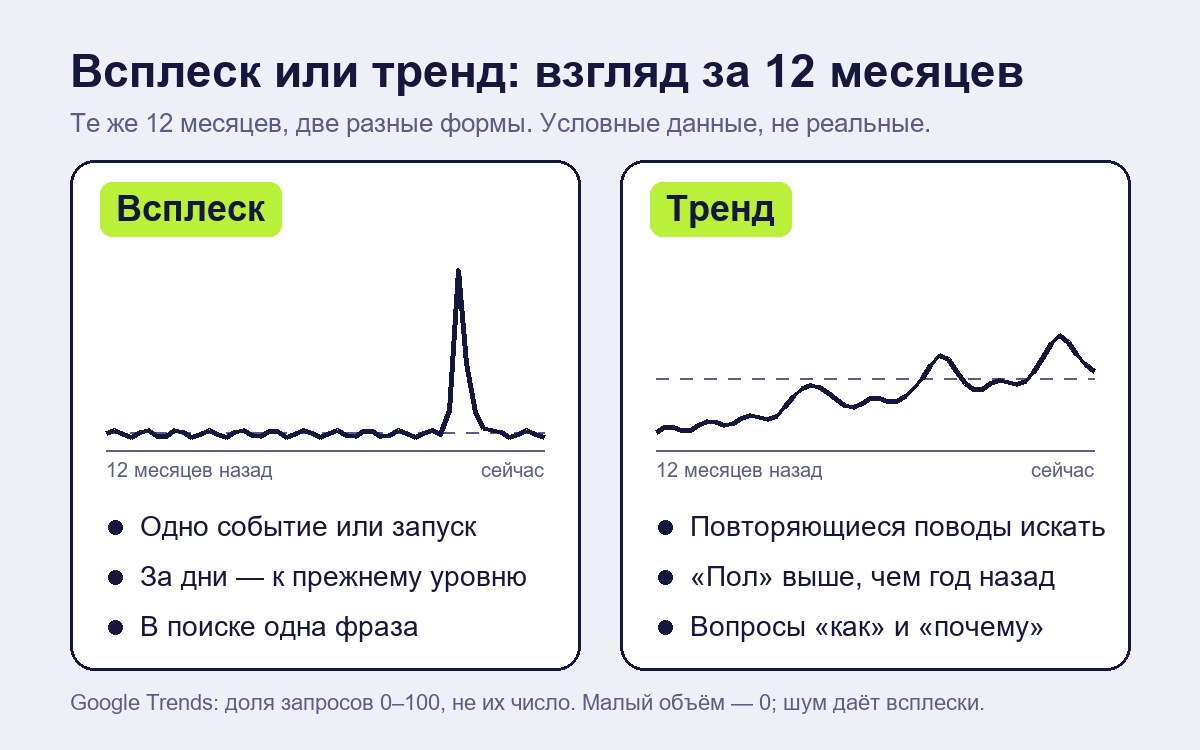
| Всплеск | Тренд | |
|---|---|---|
| Форма за 12 месяцев | Один резкий пик, возврат к прежнему уровню | Более высокий «пол», чем год назад, даже после пиков |
| Причина | Одно событие, запуск, кампания или смена данных | Повторяющиеся поводы искать, создавать или обсуждать |
| Похожие запросы | Одна фраза из заголовка | Расширяющийся набор практических вопросов (как, почему, в сравнении с) |
| Другие типы сигналов | Движется только внимание | Движутся разработчики, внимание и спрос, не обязательно вместе |
| Можно ли купить? | Часто — из дешёвых, легко накручиваемых источников | Труднее подделать сразу в независимых источниках |
Третья строка полезнее всего для авторов. Всплеск даёт много запросов с одним и тем же названием. Тренд порождает новые вопросы: как настроить, почему не работает, с чем сравнивают. Именно на эти вопросы может ответить статья.
Пять проверок перед тем, как писать о растущей теме
Эти проверки взяты из исследовательских заметок, на которых построена серия. Это рабочий метод, а не проверенная модель, и первые недели его применения лучше считать калибровкой.
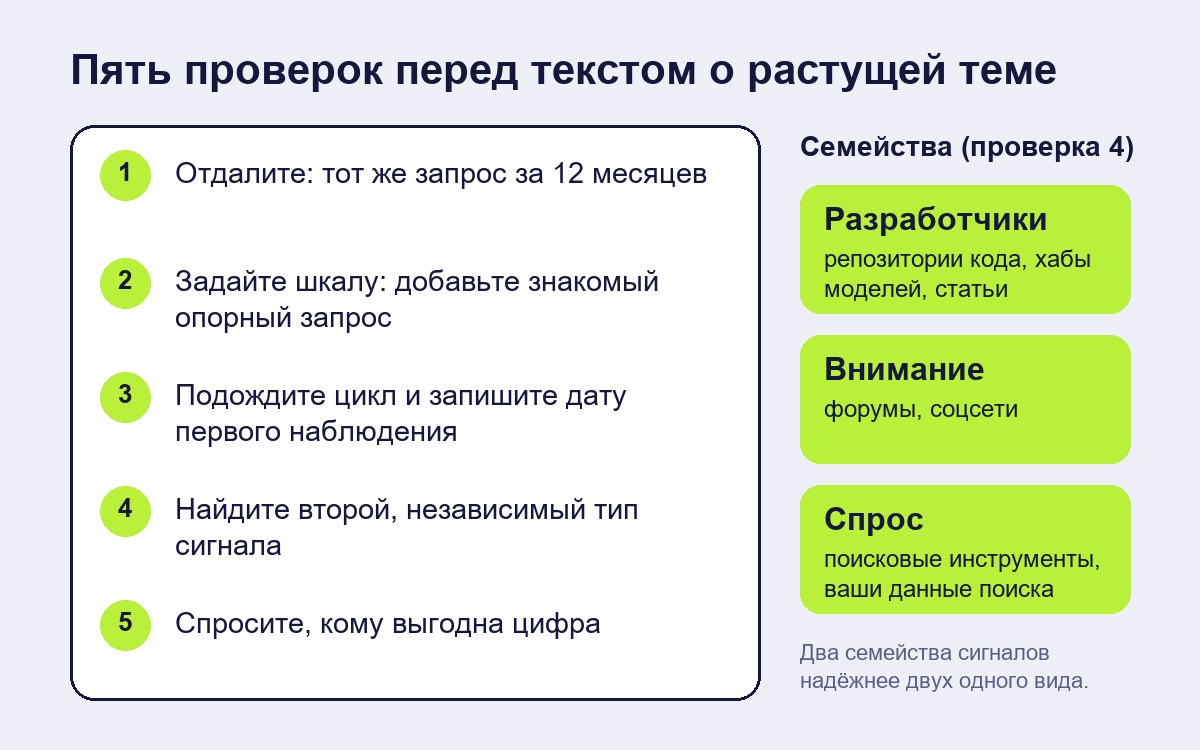
- Отдалите масштаб. Посмотрите тот же запрос за 12 месяцев, а не только за последние семь дней. Если недавний пик лишь возвращает линию туда, где она была год назад, это не новинка. Для терминов с несколькими значениями проверьте и тему, и обычный поисковый запрос.
- Задайте шкалу. Добавьте знакомый запрос для сравнения, как советует сам Google [1]. Рост, который исчезает рядом со скромным опорным запросом, мал, что бы ни говорил процент. Метку «Прорыв» читайте как «быстрый рост от неизвестной базы».
- Подождите один цикл и запишите дату. Зафиксируйте, когда впервые увидели сигнал, и посмотрите снова через неделю. Всплеск обычно выдаёт себя за несколько дней. Простой журнал (тема, сигнал, дата первого наблюдения, что вы могли бы добавить, решение, результат через четыре недели) заодно накапливает единственное свидетельство об упреждении, которое вы можете получить: своё собственное.
- Найдите второй, независимый тип сигнала. Исследовательские заметки делят сигналы на три семейства: разработчики (репозитории кода, хабы моделей, статьи), внимание (форумы, соцсети) и спрос (поисковые инструменты, ваши данные поиска). Два сигнала из одного семейства могут иметь общую причину. Два из разных — лучшее доказательство. Предлагаемое правило: писать, когда совпали как минимум два типа и вам есть что добавить; наблюдать, когда есть один сигнал или нет своего ракурса; пропустить, когда единственные свидетельства идут из легко покупаемых источников.
- Спросите, кому выгодна эта цифра. Число звёзд и места в трендах можно накрутить [5][6]. Если рост напрямую выгоден тем, кто стоит за проектом или токеном, придавайте ему меньший вес, пока его не подтвердит что-то, что труднее подделать.
Разбор примера (вымышленного)
Тема и цифры в этом разделе вымышлены, чтобы показать метод.
Допустим, в понедельник в похожих запросах к популярному запросу про кошельки появляется с меткой «Прорыв» термин, обозначающий новую функцию кошелька. За семь дней график поднимается почти с нуля до 100.
Масштаб в 12 месяцев показывает, что до прошлой недели не было ничего: термин действительно новый, так что проверка 1 вопрос не решает. Добавление популярного запроса про кошельки как опорного превращает новую линию в тонкую рябь: внимание реальное, но небольшое. Через неделю линия падает до трети пика. Одно это говорило бы о всплеске вокруг одного анонса.
Но похожие запросы изменились. Вместо названия продукта люди теперь ищут «как включить» и «безопасно ли это». У небольшой open-source-библиотеки, реализующей функцию, появились несколько десятков новых форков и открытых issues, а не только звёзды. Два семейства, спрос и разработчики, теперь указывают в одну сторону, а вопросы достаточно конкретны, чтобы на них ответить.
Решение: понаблюдать ещё неделю и подготовить короткий пояснительный материал, а не публиковать в понедельник текст «следующее большое событие». Если вопросы продолжат поступать, материал готов. Если прекратятся, ничего не потеряно.
Чего эта статья не может сказать
Она не может сказать, насколько рано срабатывает какой-либо сигнал. Независимого исследования, измеряющего упреждение, ни для одного из рассмотренных источников не нашлось, а пять проверок экспериментально не испытаны. Выводы о Flu Trends и работе Чхве и Вэриана основаны на поисковых данных о здоровье и экономике, а не о технологиях и Web3. Исследование астротурфинга описывает тренды Twitter до того, как платформа стала X, а цифры о TikTok взяты из отчёта вендора. Разобранный пример вымышлен.
Как сделана эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверено |
|---|---|---|---|
| Исследование | Собрал источники об инструментах трендов, поисковых данных и манипулируемых сигналах в исследовательские заметки | Выбрал вопрос и источники, на которые опираться | Цифры и цитаты сверены со справкой Google, работами или их официальными аннотациями, блогом arXiv и опубликованным отчётом [1]–[8] |
| Черновик | Написал первый черновик по заметкам | Отредактировал текст, проверки и разбор примера | Отдельное ревью сверило цифры и утверждения с источниками |
| Изображения | Создал обложку в стиле фотографии | Выбрал иллюстрацию; нарисовал поясняющие схемы | Помечено как созданное ИИ в строке раскрытия и в alt-тексте |
| Не делал ИИ | — | Решение о публикации и ответственность за текст | — |
Конфликт интересов: нет. У автора нет коммерческих отношений с названными компаниями, исследователями и организациями; тема в примере вымышлена.
Ответственный за статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Пометки: официальный (собственная страница организации), работа (рецензируемое или препринт-исследование, прочитанное целиком или по официальной аннотации), рабочая статья, отчёт (исследование вендора в публикации отраслевой прессы).
- Google Trends Help, «FAQ about Google Trends data». https://support.google.com/trends/answer/4365533 Официальный.
- Google Trends Help, «Related topics and queries» (Top, Rising, Breakout). https://support.google.com/trends/answer/4355000 Официальный.
- Hyunyoung Choi, Hal Varian, «Predicting the Present with Google Trends», рабочая статья Google (черновик от 10 апреля 2009 года); позже опубликована в Economic Record 88 (2012). https://static.googleusercontent.com/media/www.google.com/en//googleblogs/pdfs/google_predicting_the_present.pdf Рабочая статья, прочитана целиком. Версия из журнала: https://doi.org/10.1111/j.1475-4932.2012.00809.x
- David Lazer, Ryan Kennedy, Gary King, Alessandro Vespignani, «The Parable of Google Flu: Traps in Big Data Analysis», Science 343 (14 марта 2014 года), 1203–1205. https://doi.org/10.1126/science.1248506 ; копия авторов: https://gking.harvard.edu/files/gking/files/0314policyforumff.pdf Работа, прочитана целиком.
- Tuğrulcan Elmas, Rebekah Overdorf, Ahmed Furkan Özkalay, Karl Aberer, «Ephemeral Astroturfing Attacks: The Case of Fake Twitter Trends», IEEE Euro S&P 2021. https://arxiv.org/abs/1910.07783 Работа, официальная аннотация.
- Hao He, Haoqin Yang, Philipp Burckhardt, Alexandros Kapravelos, Bogdan Vasilescu, Christian Kästner, «Six Million (Suspected) Fake Stars in GitHub: A Growing Spiral of Popularity Contests, Spams, and Malware», arXiv:2412.13459. https://arxiv.org/abs/2412.13459 Работа (препринт), официальная аннотация.
- arXiv blog, «Fair Moderation, Equitable Access, and AI: arXiv's Updated Rate Limit Policy» (1 октября 2026 года). https://blog.arxiv.org/2026/10/01/updated-rate-limit-policy/ Официальный.
- Marketing-Interactive, «Only a fraction of TikTok trends last beyond two weeks, Publicis Groupe finds» (исследование Publicis Groupe APAC). https://www.marketing-interactive.com/only-a-fraction-of-tiktok-trends-last-beyond-two-weeks-publicis-groupe-finds Отчёт.











