
ИИ-инструменты помогали проводить описанное здесь исследование стиля, собирать материалы и писать первый черновик этой статьи. Я отредактировал текст и сверил цифры с файлами исследования и внешними источниками, перечисленными в конце. Исследование — внутренний рабочий документ, подготовленный для Dapp.Expert с помощью ИИ-инструментов; научного рецензирования оно не проходило. Обложка создана ИИ. Подробности в конце.
В последних трёх частях этой серии было много чисел. Итан Моллик (Ethan Mollick) употребляет «я» около 16,8 раза на 1000 слов. Бенедикт Эванс (Benedict Evans) задаёт больше вопросов, чем двое других авторов, которых мы изучали. В текстах Молли Уайт (Molly White) больше всего ссылок и чисел. Все эти цифры взяты из одного источника: исследования стиля трёх авторов, которое мы провели для Dapp.Expert в ноябре 2026 года [S].
Каждый раз в статье стояла пометка: внутреннее исследование, не рецензировалось. Эта часть объясняет, что за такой пометкой скрывается, и задаёт вопрос, важный далеко за пределами нашей работы: что делает утверждение о чьём-то стиле письма достойным доверия? Те же вопросы применимы к любому анализу, превращающему текст в числа: будь то исследование известных эссеистов, «оценка тональности» крипто-токена или инструмент, который говорит, что текст написан ИИ.
Это одиннадцатая и последняя часть серии о голосе и доверии в редакторской работе. Прежние части были о доказательствах, раскрытии использования ИИ, исправлениях, атрибуции, уверенности, голосе, ритме и о том, как строят аргументы Моллик, Эванс и Уайт. Здесь стандарты самой серии применены к исследованию, на котором держались три последние части.
Почему о стиле легко утверждать и трудно проверять
«У неё короткие предложения». «Он много оговаривается». «Их тон ироничен». Такие фразы звучат как наблюдения, но в каждой спрятаны два вопроса: по сравнению с чем и как измерено?
Наша прежняя работа хорошо показывает эту проблему. До исследования трёх авторов мы составили широкий обзор 148 известных авторов и оценили каждого по таким шкалам, как ирония, использование метафор и открытость в обращении с неопределённостью [A]. Как карта он был полезен. Как измерение — нет. Хотя бы один текст реально прочитан лишь у 45 из 148 авторов; о 101 мы судили по справочным страницам, в основном из Википедии, а у 66 из них стилевые метки взяты только из короткой пометки о «тоне» в нашем каталоге [A]. Все оценки по шкалам — суждение одного исследователя, ИИ-инструмента, и никто не проверял, поставит ли второй человек те же оценки [A].
Обзор сам перечисляет эти ограничения. Но читатель, увидевший одну оценку («ирония: 1 из 5»), не мог знать, что она может держаться на одном предложении справочной статьи. Исследование трёх авторов задумывалось, чтобы сделать лучше.
1. Достаточно настоящего текста, выбранного по правилу
Первый вопрос: что на самом деле прочитано. В исследовании использованы 24 поста Моллика (около 43 600 слов), 28 эссе Эванса (около 52 800) и 26 текстов Уайт (около 63 700), все в открытом доступе [P]. Тексты выбирали не потому, что они знамениты или цитируемы. Их выбирали по заявленному правилу, с разбросом по годам, жанрам и темам каждого автора; скрипты отбора и фиксированное случайное зерно записаны [P][E]. Пять самых известных текстов каждого автора отмечены отдельно, чтобы одно известное эссе не задавало незаметно тон всему профилю [E].
Платная еженедельная рассылка Эванса и его ежегодные презентации, возможно, главные его форматы, в корпус не вошли [E]. В постах Моллика есть запросы и ответы ИИ, которые попали в некоторые подсчёты [P]. В текстах Уайт встречается неотмеченная прямая речь других людей — стенограммы и пересказанные показания, — и это может размывать её собственный профиль [P].
Что спросить: сколько полных текстов? Как выбраны? Что исключено, и могло ли исключение изменить результат?
2. По сравнению с чем?
«16,8 употреблений „я“ на 1000 слов» мало что значит без другого числа рядом. Обычное сравнение — большой справочный корпус языка, построенный так, чтобы представлять разные виды письма. Задание исследования такого требовало, но пилот его дать не смог: один из широко используемых вариантов, Corpus of Contemporary American English, продаёт полнотекстовые данные [3], а Британский национальный корпус, собрание из 100 миллионов слов, представляет британский английский «конца XX века» [4].
Поэтому исследование сравнивало каждого автора с двумя другими [P]. Это законный выбор, но он меняет смысл чисел. Моллик с 16,8 употребления «я» на 1000 слов против 6,4 у Эванса и 9,8 у Уайт [E] показывает, что он пользуется первым лицом чаще, чем эти двое. Он не показывает, что часто по меркам английской прозы вообще. Когда в трёх прошлых частях говорилось «больше» или «меньше», это значило «внутри этой группы из трёх».
Что спросить: какая база сравнения? «Высокий» результат высок относительно языка, жанра или двух других людей?
3. Два кодировщика и мера их согласия
Для скрипта подсчитать слова легко. Распознать оговорку, аналогию или эксперимент над собой требует суждения читателя. Стандартная защита: два кодировщика независимо размечают одни и те же фрагменты, и измеряется их согласие.
Простое согласие завышает надёжность, потому что два кодировщика, которые гадают, иногда совпадают случайно. В 1960 году статистик Джейкоб Коэн (Jacob Cohen) предложил меру, каппу, которая это поправляет [1][2]. Каппа 1 означает полное согласие; 0 — не лучше случайного. По правилу самого Коэна, значения от 0,41 до 0,60 — «умеренное» согласие, от 0,61 до 0,80 — «существенное», а обзор 2012 года в журнале Biochemia Medica утверждает, что для медицинских исследований эта шкала может быть слишком мягкой, поскольку допускает приемлемой каппу даже 0,41 [2]. В задании нашего исследования планка стояла на 0,6 [P].
Вот что получилось. Для каждого автора около 10% фрагментов размечено дважды: 50 из 491 у Моллика, 51 из 518 у Эванса, 70 из 701 у Уайт [M][E][W]. Первым проходом были автоматические правила; вторым — прочтение ИИ-агентом [P]. Средняя каппа составила 0,505 у Моллика, 0,618 у Эванса и 0,514 у Уайт, то есть двое из троих оказались ниже планки [P]. Даже проходной средний показатель Эванса скрывал два слабых признака: атрибуцию (0,33) и аналогию (0,32) [E].
Затем исследование добавило третий, слепой проход: отдельный машинный кодировщик, который видел только кодбук и фрагменты, без доступа к прежним меткам [P]. Два прочтения совпали друг с другом гораздо точнее, чем любое из них с правилами: в среднем 0,859, 0,910 и 0,937, и ни один признак не ниже 0,70 [P]. По всем трём проходам вместе (каппа Флейса) согласие было ниже: 0,600, 0,713 и 0,654 [P]. Значит, главным источником расхождений были автоматические правила, а не сами признаки. Оговорку добавляет сам отчёт: оба прочтения сделаны машинами, а у машин может быть общая предвзятость [P].
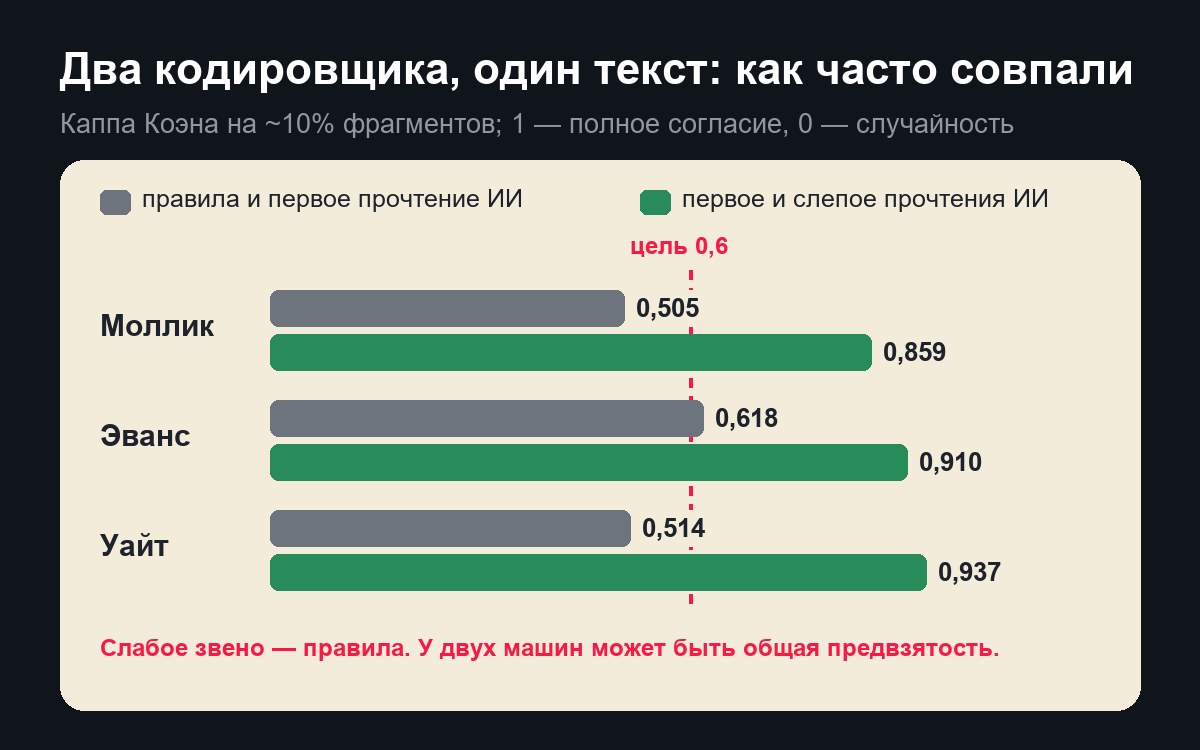
Что спросить: размечали ли один и тот же материал два независимых кодировщика? Каково согласие по каждому признаку, а не только в среднем? Это были люди или машины, у которых может быть общая предвзятость?
4. Определения, которые может применить второй читатель
Низкое согласие часто — симптом расплывчатого определения. Отчёт пилота откровенно говорит, где подвёл кодбук. «Аналогия» была определена слишком широко, а правила не видели метафору без слова «как»; «атрибуцию» путали с простым описанием события [P]. Именно у этих признаков согласие оказалось слабейшим: каппа от 0,12 до 0,48 по трём авторам [M][E][W].
Предложенное исправление конкретно [P]. Разделить «аналогию» на явное сравнение, метафору, определяемую по опубликованной процедуре (MIPVU, метод, разработанный лингвистами из Амстердамского свободного университета [5]), и идиому. Считать «атрибуцию» только при явном источнике: ссылке, документе или имени. И дать для каждого признака по три положительных и по три отрицательных примера, чтобы новый кодировщик видел границу.
Что спросить: мог ли кто-то другой применить определения и получить те же метки? Есть ли примеры того, что не считается?
5. Цитаты проверяет машина, а не память
Исследование стиля живёт цитатами, а в цитатах и закрадываются ошибки: фраза, приписанная не тому эссе, пересказ, поданный как цитата. Исследование запускало скрипт, проверявший каждую цитату, отнесённую к тексту корпуса: что она действительно есть в этом тексте и не длиннее 15 слов [P]. Проверено 63 из 76 строк цитат у Моллика, 59 из 80 у Эванса и 65 из 77 у Уайт; остальное — заголовки (их нет в основном тексте), шаблоны вроде «If you…, you should…», русскоязычные пересказы и названия категорий Appraisal [P].
Проверка нашла настоящие ошибки: одну цитату, привязанную не к тому эссе Эванса, и неверную ссылку на текст в исследовании Уайт [P].
Что спросить: сверялись ли цитаты с оригиналом? Что проверить не удалось и почему?
6. Каждое утверждение помечено происхождением
Во всех трёх исследованиях утверждения отмечены как подкреплённые источником, полученные из корпуса или как предположение исследователя [E]. История карьеры Эванса подкреплена источником; средняя длина его предложения около 24 слов — результат по корпусу; мнение, что его аудитория — в основном технические руководители и инвесторы, помечено как предположение, потому что данных о его подписчиках нет [E].
Та же честность нужна для закономерностей, которые держатся на одном тексте. Четыре из описанных у Уайт приёмов встречаются только в одном из её текстов [P]. Отчёт предлагает для таких случаев отдельный статус, примерно «приём знакового текста», вместо подачи их как общих привычек [P].
Что спросить: можно ли отличить, какие утверждения измерены, какие подкреплены источником, а какие — догадки автора?
7. Оценка и причина оценки
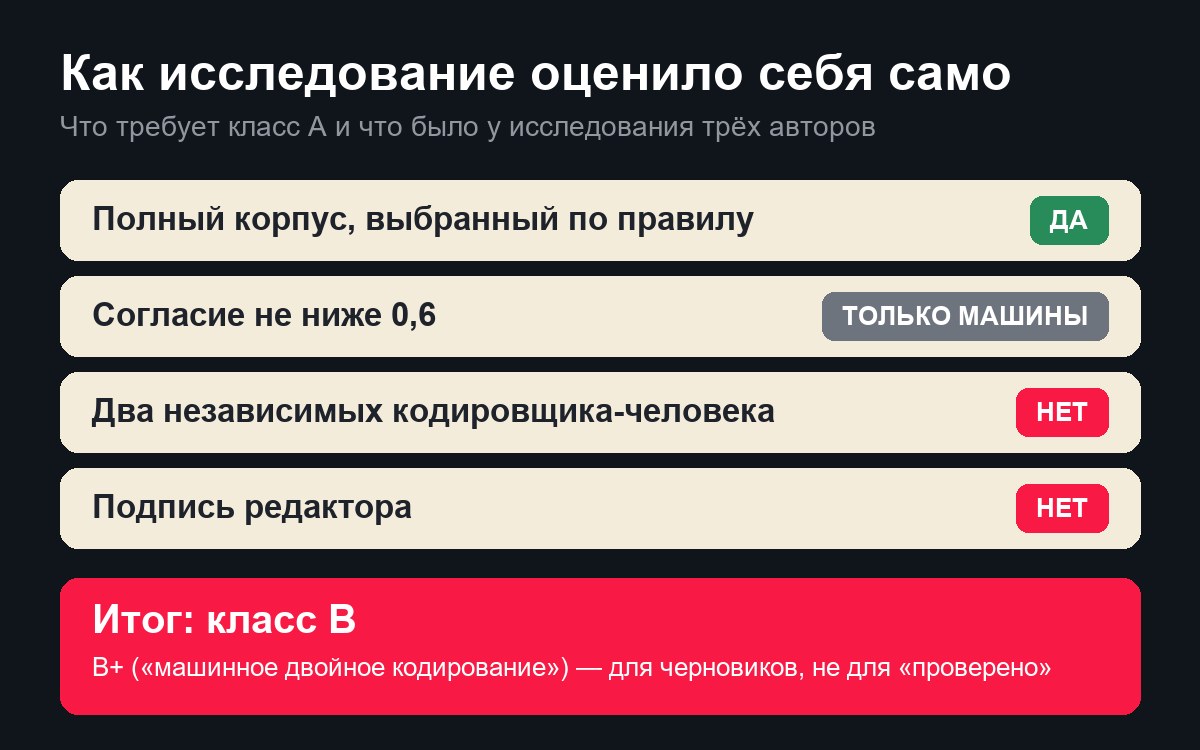
Последняя проверка проще всего формулируется и реже всего встречается: исследование ставит оценку само себе. В задании класс A определён как полный корпус плюс два независимых кодировщика-человека, каппа не ниже 0,6 и подпись редактора [P]. Часть про корпус этому стандарту соответствовала для всех трёх авторов. Остальное нет: второго кодировщика-человека не было, двое авторов не дотянули до планки каппы при первом сравнении, и ни одно исследование не подписал редактор. Все три получили класс B [P].
После слепого третьего прохода отчёт предложил промежуточную метку B+ («машинное двойное кодирование»): корпус уровня A и два машинных прочтения, одно из них слепое, согласующиеся на 0,6 и выше по каждому признаку, без кодировщика-человека и редактора [P]. Позднее внутреннее ревью, проведённое панелью из трёх ИИ-моделей, запущенной другой ИИ-системой и проверенное вручную, пришло к выводу, что B+ годится для внутренних черновиков и пометок, но не для публичного описания выводов как «проверенных» [R]. Поэтому в трёх прошлых частях говорилось «наши подсчёты» и «в нашем прочтении», а не «доказано».
Семь вопросов к любому анализу стиля
Эти проверки применимы всякий раз, когда кто-то превращает текст в вердикт: «этот автор осторожнее», «сообщество этого токена настроено оптимистично», «это эссе написано ИИ».
| Вопрос | Что сделало наше исследование |
|---|---|
| Достаточно полных текстов, выбранных по правилу? | Да: от 24 до 28 на автора, по году, жанру и теме, с зерном |
| Сравнение с названной базой? | Частично: с двумя другими авторами, а не с языком в целом |
| Два независимых кодировщика? | Только машины: правила, затем два прочтения ИИ, второе слепое |
| Согласие приведено по каждому признаку? | Да, включая слабые |
| Определения с примерами? | Пока нет: предложен пересмотренный кодбук |
| Цитаты сверены с оригиналом? | Да, скриптом; то, что проверить не удалось, перечислено |
| Оценка с причинами? | Да: класс B; B+ для внутреннего использования (для Уайт — после одного открытого решения) |
Форум, числа и инструмент ниже выдуманы для иллюстрации.
Утверждение: «Наш ИИ-инструмент проанализировал форум сообщества DeFi-протокола: тональность на 78% положительная».
Вопросы: какие посты прочитаны, исключены ли удалённые посты и аккаунты ботов? Положительная по сравнению с чем: тот же форум месяц назад или другие протоколы? Кто сверил метки инструмента с прочтением человека и как часто они совпали? Включает ли «положительная» сарказм? Без этих ответов 78% — число без смысла, как бы точно оно ни выглядело.
Чего эта статья не может сказать
Статья описывает одно исследование, оценённое изданием, которое его заказало. Dapp.Expert использует исследование для проектирования стилей своих ИИ-авторов, поэтому заинтересован в том, чтобы оно выглядело обоснованным. Взвешивайте дальнейшее с учётом этого. Пилот охватил трёх авторов на английском; он пока ничего не говорит об остальных авторах нашего обзора, о русскоязычных авторах и о коротких форматах вроде тредов [P]. Обсуждаемые здесь пороги, например каппа 0,6, — условности, а не законы; в разных областях планка разная [2].
Статья также не может сказать, верны ли выводы исследования о каждом авторе. Хорошо задокументированное исследование всё равно может ошибаться. Документация даёт возможность увидеть, где оно может ошибаться.
Как создана эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверено |
|---|---|---|---|
| Исследование | Провёл отбор корпуса, метрики, проходы разметки и проверки цитат; подготовил черновики отчётов исследования | Задал задание и его стандарты (вопросы, критерии класса A); решил о третьем слепом проходе. Трёх авторов в рамках задания выбрал ИИ-исполнитель | Отчёт пилота, исследования по каждому автору и внутреннее ревью тремя моделями с ручными проверками |
| Черновик | Написал первый черновик по файлам исследования | Отредактировал текст и структуру | Каждая цифра сверена с файлами исследования; внешние факты проверены по страницам, перечисленным ниже, 15 ноября 2026 года |
| Изображения | Создал иллюстрацию для обложки; разложил схемы по шаблону серии | Утвердил иллюстрацию и схемы | Помечено как созданное ИИ в строке раскрытия и в альтернативном тексте |
| Не делал ИИ | — | Решение о публикации и ответственность за текст | — |
Конфликт интересов: Dapp.Expert заказал исследование стиля и использует его для проектирования своих ИИ-авторов; эта статья оценивает это исследование. Итан Моллик, Бенедикт Эванс и Молли Уайт не участвовали ни в этой статье, ни в исследовании.
Ответственный за статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Пометки: исследование, официальная страница, внутреннее исследование.
- Cohen, J. "A Coefficient of Agreement for Nominal Scales." Educational and Psychological Measurement 20(1), 1960, 37–46. Исследование. https://doi.org/10.1177/001316446002000104
- McHugh, M. L. "Interrater reliability: the kappa statistic." Biochemia Medica 22(3), 2012, 276–282. Исследование (обзор). https://pmc.ncbi.nlm.nih.gov/articles/PMC3900052/
- English-Corpora.org, "Full-text corpus data" (COCA и другие корпуса; страница покупки). Официальная страница. https://www.corpusdata.org/
- British National Corpus, "About the British National Corpus". Официальная страница. http://www.natcorp.ox.ac.uk/corpus/index.xml
- Steen, G. J., Dorst, A. G., Herrmann, J. B., Kaal, A. A., Krennmayr, T., & Pasma, T. A Method for Linguistic Metaphor Identification: From MIP to MIPVU. John Benjamins, 2010. Исследование. https://benjamins.com/catalog/celcr.14
Файлы внутреннего исследования (Dapp.Expert, рабочие документы, не рецензировались):
- [S] Исследование стиля трёх авторов (Моллик, Эванс, Уайт), ноябрь 2026: отчёт пилота и исследования по каждому автору. Внутреннее исследование.
- [P] Отчёт пилота: исследование стиля трёх авторов, 4 ноября 2026, включая третий слепой проход. Внутреннее исследование.
- [M], [E], [W] Исследования по авторам: Итан Моллик, Бенедикт Эванс, Молли Уайт, 4 ноября 2026. Внутреннее исследование.
- [A] Анатомия стиля 148 эталонных авторов, 4 ноября 2026. Внутреннее исследование.
- [R] Внутреннее ревью исследований авторов панелью из трёх ИИ-моделей, проверено вручную, 5 ноября 2026. Внутреннее исследование.











