
Небольшая аудитория помогает заметить непонятный заголовок. Но чтобы доказать, что один ясный заголовок собирает больше кликов, чем другой, может потребоваться намного больше трафика. До запуска решите, на какой вопрос ваш тест реально способен ответить.
Отделите понимание от кликов
Спросите нескольких читателей, что, по их ожиданиям, объяснит статья, когда они видят её заголовок. Ответы могут выявить двусмысленность или необоснованное обещание. Это полезная качественная проверка, но она не оценивает рост кликабельности.
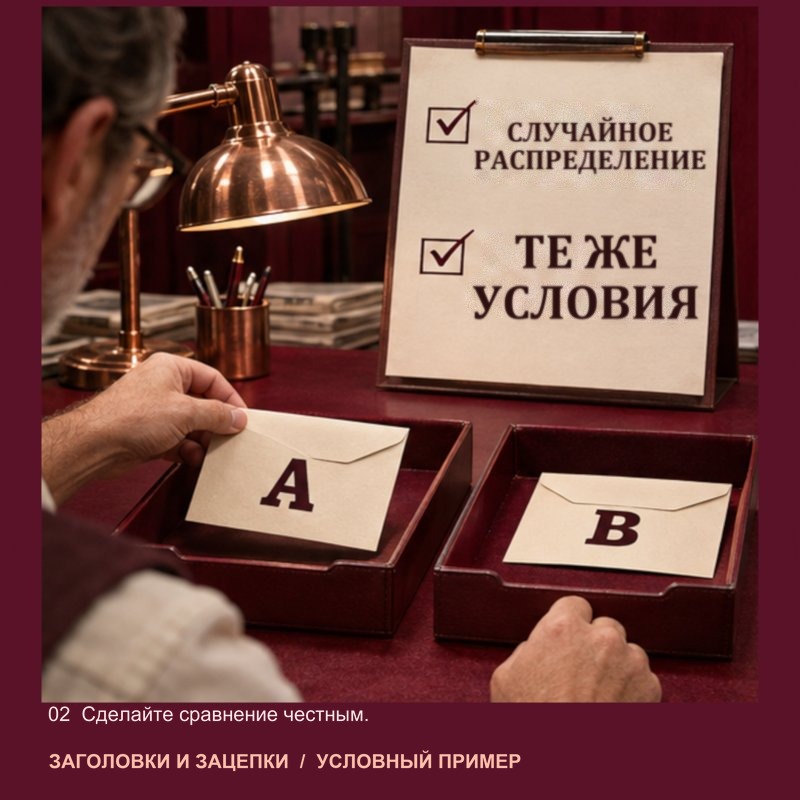
Причинное сравнение кликов требует схемы, при которой группы сопоставимы. В идеале подходящих читателей случайно распределяют между заголовками A и B, сохраняя одинаковыми статью, размещение и другие важные условия. Два органических поста в разные дни могут отличаться временем, аудиторией и распространением, а не только заголовками.
Определите решение до теста
Зафиксируйте два варианта, подходящую аудиторию, основную метрику и правило остановки. Для кликабельности (CTR) сохраняйте число кликов и число показов подходящей аудитории, а не только процент. Решите, какой размер улучшения важен на практике.
В руководстве по планированию экспериментов Листа, Садоффа и Вагнера объясняется, почему необходимый размер выборки зависит от эффекта, который вы хотите обнаружить, от разброса данных и выбранных уровней ошибок. Для бинарного исхода, такого как клик, важна и базовая доля кликов. Универсального порога вроде 100 показов или семи дней, при котором любой тест надёжен, не существует. Повторные показы одному читателю также нельзя автоматически считать независимыми участниками.
Два лишних клика могут ничего не доказывать
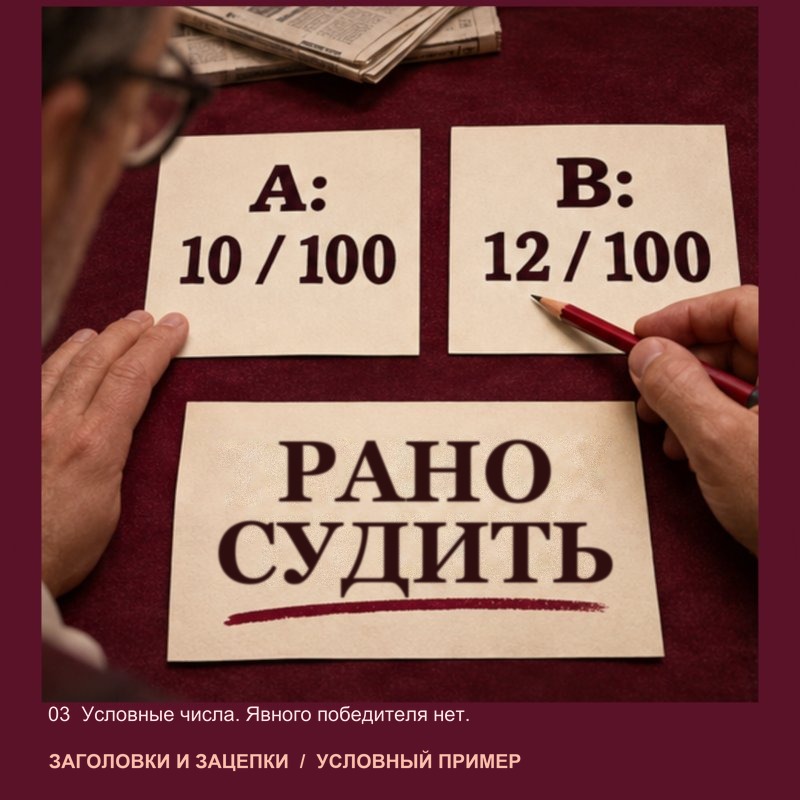
Представьте две случайно сформированные группы по 100 независимых читателей. На заголовок A кликнули десять человек, на заголовок B — двенадцать. Эти вымышленные числа дают доли 10% и 12%, то есть разницу в два процентных пункта. Грубое нормальное приближение даёт стандартную ошибку разности около 4,4 процентного пункта. Наблюдаемый разрыв невелик по сравнению с этой неопределённостью.
Это иллюстративный расчёт, а не настоящий эксперимент и не универсальная рекомендация по размеру выборки. Он не определяет победителя и не доказывает, что заголовки работают одинаково. На малых выборках решение может остаться неопределённым.
Соблюдайте правило остановки честно
При обычном анализе с фиксированной выборкой не заканчивайте тест при первом благоприятном результате. Джохари, Пелекис и Уолш обсуждают, почему для непрерывного наблюдения нужны подходящие статистические методы. Корректный последовательный план допускает повторные проверки, но эти методы должны входить в анализ.
Если трафик не позволяет различить значимую разницу, выбирайте по ясности, точности и реальному обещанию статьи. Отметьте тест как неубедительный. К вопросу можно вернуться позже, когда будет больше подходящих данных.
Небольшой тест полезен, когда решение соответствует данным. Приводите вместе числа, условия и степень неопределённости.











