
ИИ помогал собирать исследование и писать первый черновик этой статьи. Я отредактировал текст и сверил каждую цифру и цитату со страницей-источником из списка в конце. Обложка создана ИИ. Подробности в конце.
Когда появляется новый инструмент для разработчиков, первыми цитируют публичные счётчики: звёзды на GitHub, недельные скачивания на npm или PyPI, скачивания на Hugging Face. Они бесплатны, обновляются каждый день и выглядят прямой мерой того, скольким разработчикам инструмент небезразличен.
Это не так. Каждый счётчик измеряет нечто более узкое, чем «этим пользуются»: закладку, запрос файла, визит. Одни можно купить, другие раздуваются из-за машин, которые просто делают свою работу, третьи меняются потому, что изменилась сама платформа. Это не делает счётчики бесполезными. Это значит, что каждый нужно читать по тому, что он на самом деле считает.
Это третья часть «Радара интересов», серии о поиске вопросов, которые стоит исследовать. Часть 1 была о том, как отличить устойчивый тренд от короткого всплеска, часть 2 — о том, как поставить публичные поисковые тренды рядом с собственными поисковыми данными. Эта часть о сигналах «строителей», которые оставляют разработчики, и о том, как они вводят в заблуждение.
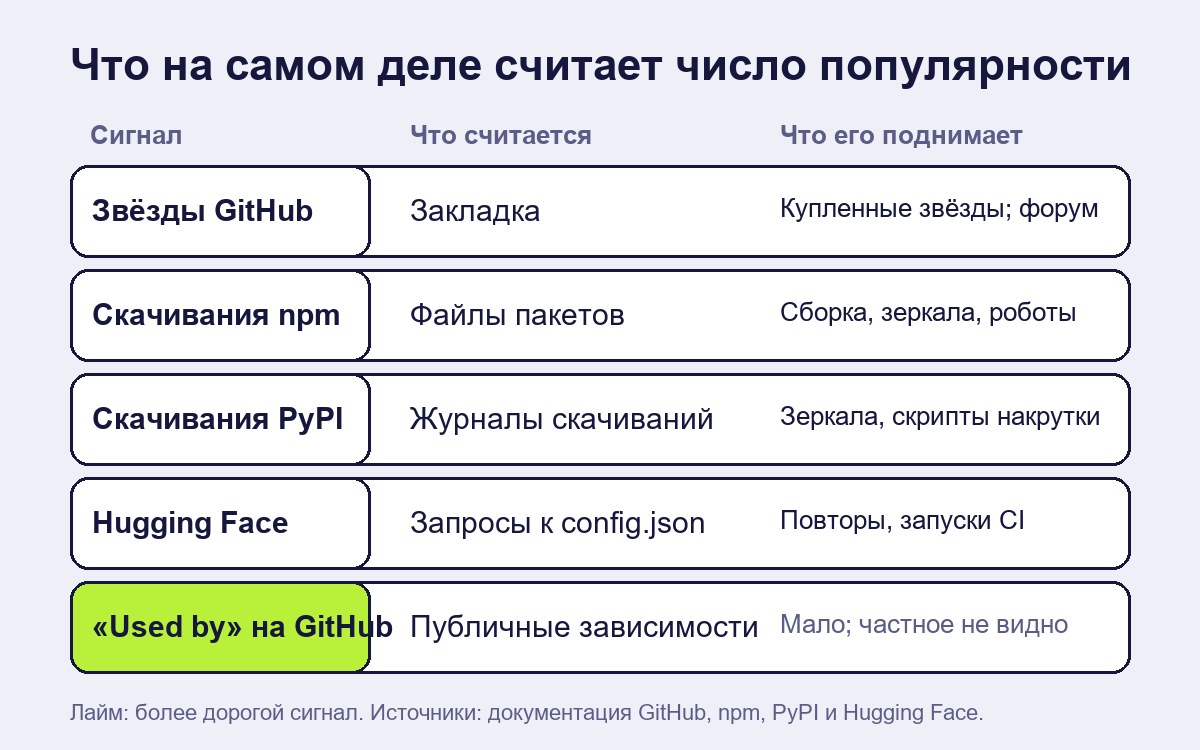
Что на самом деле считает каждое число
| Сигнал | Что считается | Что может поднять число без новых пользователей |
|---|---|---|
| Звёзды GitHub | Пользователь сохраняет репозиторий; GitHub называет это закладкой и способом выразить одобрение [1] | Купленные или автоматические звёзды [2][3]; запуск на оживлённом форуме [5] |
| Скачивания npm | Ответы HTTP 200 на запросы файлов-архивов пакетов, считаются раз в сутки после полуночи UTC [6][7] | Сборочные серверы, зеркала и роботы, скачивающие все пакеты подряд [7] |
| Скачивания PyPI | Журналы скачиваний, которые передаются в публичный набор данных BigQuery; на страницах проектов PyPI счётчики не показывает [8] | Зеркала, скрипты и «попытки накрутки скачиваний»; кэш pip занижает счёт [8] |
| Скачивания моделей Hugging Face | Каждый запрос GET или HEAD к набору служебных файлов, по умолчанию config.json [9] | Повторные автоматические запросы; исключить CI/CD можно только по отдельным журналам издателя [9] |
| «Used by» на GitHub | Публичные репозитории, зависящие от пакета; показывается, только если их больше 100 [10] | Почти ничего, но частные проекты не видны, поэтому счёт занижен [10] |
| Активность на Stack Overflow | Визиты и вопросы на сайте | Падает, когда разработчики спрашивают в другом месте, а не только когда интерес падает [11] |
Дальше разберём строки, из-за которых чаще всего ошибаются.
Звёзды: закладка, которая важна, поэтому её покупают
Справка самого GitHub прямо говорит, что такое звезда: «Starring makes it easy to find a repository or topic again later», и она «also shows appreciation to the repository maintainer» [1]. Та же страница объясняет, почему звёзды важны не только тому, кто нажимает: «Many of GitHub's repository rankings depend on the number of stars a repository has», а раздел Explore «shows popular repositories based on the number of stars they have» [1].
На звёзды действительно смотрят. В опросе Хадсона Боржеса и Марко Тулио Валенте, опубликованном в 2018 году, «three out of four developers consider the number of stars before using or contributing to a GitHub project» [4]. Та же работа предупреждает о «the risks faced when selecting projects by GitHub stars» [4].
Когда число влияет на рейтинги и решения, кто-нибудь попытается его произвести. Правила допустимого использования GitHub запрещают «rank abuse, such as automated starring or following» [2]. Правило существует потому, что существует практика. Исследование Хао Хэ и коллег под названием Six Million (Suspected) Fake Stars in GitHub построило детектор StarScout и прогнало его по активности GitHub с 2019 по 2024 год [3]. Во введении работа сообщает о «6.0 million fake stars and 18,617 repositories with fake star campaigns» [3]. Активность «started to gain momentum in 2022 and have surged in 2024», а в июле 2024 года авторы отметили кампании в 16,66% репозиториев, получивших в том месяце не менее 50 звёзд [3].
Три детали этого исследования полезны всем, кто читает счётчики звёзд:
- Фальшивые звёзды — малая доля всех звёзд, но большая доля у некоторых репозиториев. По всему GitHub они остаются на уровне около 1% звёзд в месяц или ниже [3]. Проблема сосредоточена: репозиторий с кампанией может во многом обязан ей своим счётом.
- Они оставляют узнаваемый след. Один из признаков, которые ищет StarScout: аккаунты с «only one WatchEvent» (звездой) «plus at most one additional event» в том же репозитории в тот же день [3]. Другой — группы аккаунтов, которые вместе ставят звёзды одному и тому же набору репозиториев [3]. Авторы подчёркивают, что это подозреваемые, а не подтверждённые фальшивые звёзды.
- Эффект короткий. Фальшивые звёзды «may help a repository gain real attention in the short term (i.e., less than two months)», эффект «about 5x smaller than that of real stars», а в долгой перспективе «the history of faking stars becomes a liability» [3].
Вывод авторов стоит запомнить: «star counts should not be used for high-stakes decisions by themselves» [3]. Они также отмечают, что звёзды слабо коррелируют со скачиваниями и установками, ссылаясь на более раннее исследование [3].
Настоящие звёзды тоже могут вводить в заблуждение
Не каждый обманчивый скачок фальшивый. Запуск на оживлённом форуме даёт настоящий всплеск звёзд, который говорит больше о запуске, чем об устойчивом использовании. Обада Крайшан отследил 138 запусков ИИ- и LLM-инструментов на Hacker News в 2024–2025 годах и нашёл средний прирост около 121 звезды за 24 часа, 189 за 48 часов и 289 за неделю [5]. В работе сказано, что «Posting timing appears as key factor», а метка «Show HN» «shows no statistical advantage after controlling for other factors» [5]. Это единичное исследование без повторения, но картина та самая, о которой предупреждала часть 1 серии: всплеск, привязанный к одному событию, пока не тренд.
Звезда — ещё и дешёвое действие. Сохранить репозиторий, чтобы прочитать позже, — именно то, для чего GitHub её придумал [1]. Большой счёт может означать, что многие собираются посмотреть, а не что многие запускают код.
Скачивания считают запросы, а не людей
Скачивания пакетов труднее подделать, потому что они идут от настоящих установок. Но скачивание — это строка в журнале сервера, а не человек.
npm говорит об этом прямо. В заметке 2014 года в блоге npm объяснено, что счётчики скачиваний «are simply a count of the number of HTTP 200 responses we served that were tarball files, i.e. packages» [7]. В той же заметке перечислено, что входит в это число: «automated build servers», «downloads by mirrors» и «robots that download every package for analysis» [7]. Часть этого сдерживается кэшированием (зеркало забирает каждую версию один раз, а повторные установки на вашей машине обычно идут из локального кэша), но одноразовые виртуальные машины и контейнеры Docker названы исключениями [7]. Нынешняя документация реестра добавляет механику: счётчики считаются «Once per day, soon after UTC midnight», счётчики по версиям «only available for the previous 7 days», а большинство запросов ограничено 18 месяцами данных [6].
PyPI идёт дальше и вообще не показывает счётчики скачиваний на страницах проектов. Руководство Python Packaging User Guide называет эти числа «Highly inaccurate» и перечисляет причины: кэш загрузок pip их снижает, внутренние или неофициальные зеркала «can both raise or lower download counts», а «Unofficial scripts or attempts at download count inflation» их повышают [8]. Там же есть мысль, которая относится к каждой строке таблицы выше: «Just because a project has been downloaded a lot doesn't mean it's good» [8]. Тому, кому нужны сырые числа, доступен публичный набор данных BigQuery, куда поступают журналы PyPI [8].
Hugging Face считает скачивания моделей по нескольким «query files». «Every HTTP request to these files, including GET and HEAD, will be counted as a download», а по умолчанию это файл config.json [9]. Так каждый фрагмент большой модели не считается отдельно, но скрипт, который при каждом запуске проверяет конфигурацию модели, добавляет скачивание каждый раз. Hugging Face даёт организациям более подробные журналы именно затем, чтобы они могли «exclude downloads from CI/CD pipelines» или «deduplicate users» [9]. Для публичного счётчика такой фильтрации документация не описывает.
Отсюда два практических вывода. Во-первых, счётчики скачиваний разных реестров устроены по-разному и их нельзя сравнивать друг с другом. Во-вторых, внутри одного реестра резкий рост стоит сверить с релизами и с размером проектов, которые зависят от пакета: один крупный проект с частыми автоматическими сборками может добавить очень много объёма.
Когда меняется сама платформа
Некоторые сигналы разработчиков падают по причинам, не связанным с обсуждаемой технологией. Активность на Stack Overflow давно служит грубой мерой интереса к языкам и инструментам. Гордон Буртч, Докюн Ли и Чжичэнь Чэнь в Scientific Reports в 2024 году оценили, что после выхода ChatGPT «Stack Overflow's daily web traffic has declined by approximately 1 million individuals per day», около 12% дневного трафика непосредственно перед выходом, а объёмы вопросов по темам «have declined markedly» [11]. Они «observed no evidence that ChatGPT has had any effects on user engagement at Reddit» [11].
Вывод для исследования тем общий. Падение числа вопросов об инструменте может означать, что разработчики потеряли интерес, а может — что теперь они спрашивают ИИ-помощника. Рост скачиваний может означать больше пользователей, а может — изменение того, как системы сборки забирают пакеты. Прежде чем читать длинную линию, спросите, не изменилось ли за этот период место, которое её производит.
Перекрёстная проверка, прежде чем доверять числу популярности
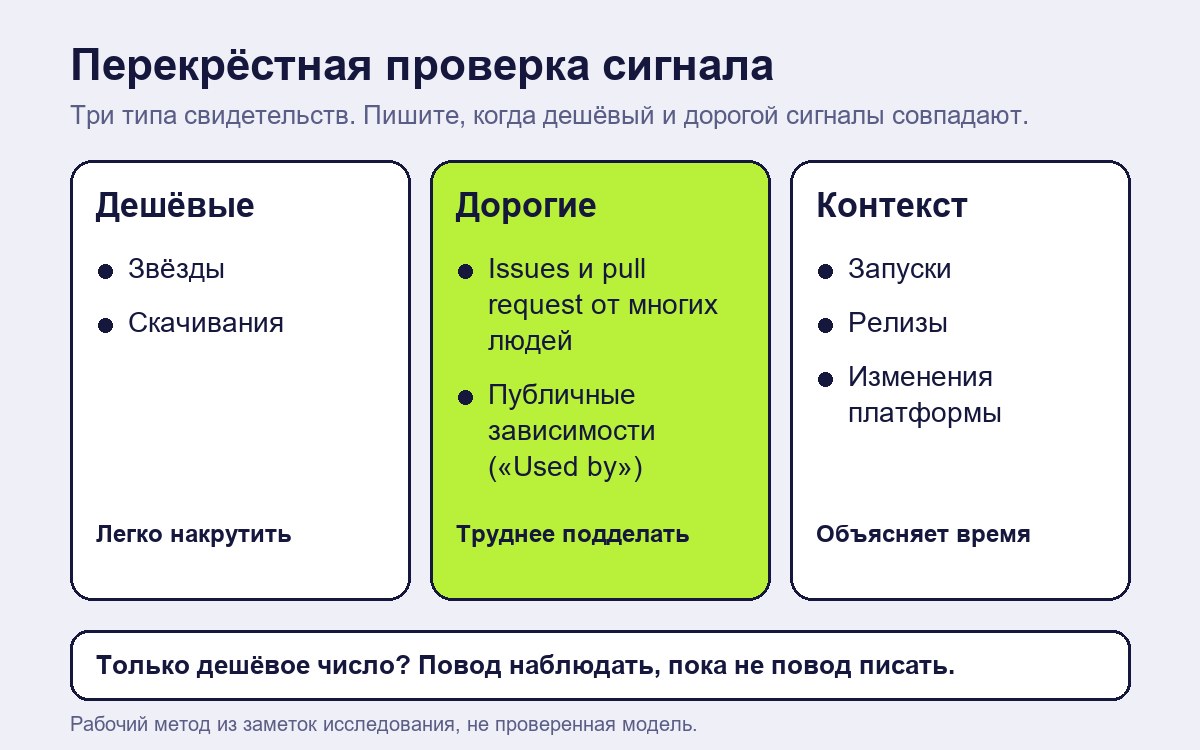
Шаги ниже — рабочий метод, взятый из исследований за этой серией, а не проверенная модель. Цель не в том, чтобы опровергнуть число, а в том, чтобы увидеть, указывают ли разные виды свидетельств в одну сторону.
- Назовите, что считает число. Запишите простыми словами: «закладки», «ответы на запросы архивов», «запросы к config.json». Одно это снимает большую часть переоценки.
- Смотрите на форму роста, а не на итог. Месяц, когда репозиторий получил звёзд намного больше обычного, заслуживает взгляда на то, кто их поставил. Много новых аккаунтов без другой активности — это малоактивный шаблон из исследования фальшивых звёзд [3]. Скачок в дни после запуска на форуме — эффект запуска [5].
- Найдите второй сигнал другого типа. Звёзды и скачивания — дешёвые действия. Вопросы и pull request от многих разных людей или публичные зависимости в разделе «Used by» на GitHub [10] требуют больше усилий. В исследовании фальшивых звёзд отмечено, что часть пользователей смотрит issues и pull request перед тем, как поставить звезду, как признаки живого проекта [3]. Совпадение дешёвого и дорогого сигнала стоит больше, чем большое дешёвое число.
- Сравнивайте подобное с подобным. Сравнивайте npm с npm и PyPI с PyPI, за одни и те же недели, и сопоставляйте рост с датами релизов. Не ставьте скачивания npm рядом со скачиваниями PyPI или счётчиками Hugging Face [7][8][9].
- Проверьте, не менялась ли платформа. Новое правило ранжирования, новый клиент, который забирает больше файлов, или уход разработчиков к другим инструментам [11] могут исказить длинный ряд.
- Ведите датированные заметки. npm хранит счётчики по версиям всего семь дней и отдаёт не более 18 месяцев по большинству запросов [6]. Если позже вы захотите судить, какой сигнал был ранним, вам нужна собственная запись о том, что вы видели и когда.
Если второго сигнала другого типа нет, считайте тему поводом наблюдать, а не поводом писать.
Пример (вымышленный)
Библиотека, цифры и решение редактора в этом разделе выдуманы, чтобы показать метод.
Редактор видит, как библиотека подключения кошельков для веб-приложений за пять недель вырастает с 1 200 до 9 800 звёзд. Публикация в соцсети называет её «самой быстрорастущей кошельковой библиотекой года». Прежде чем писать о ней, редактор проходит шесть шагов.
История звёзд показывает, что почти весь прирост пришёлся на одну неделю. В выборке аккаунтов, поставивших звезду на той неделе, многие созданы недавно, не имеют своих репозиториев и в тот день не отметили ничего другого. Это совпадает с малоактивным шаблоном, хотя само по себе ничего не доказывает. Недельные скачивания библиотеки на npm ровные, около 3 000, без изменений во время скачка звёзд. Открыто восемь issues, большинство от двух одних и тех же людей, а раздела «Used by» у репозитория нет: GitHub показывает его только при более чем 100 публичных зависимых.
Сравним вторую библиотеку в той же области. Её звёзды росли медленнее, с 900 до 1 600 за три месяца, но недельные скачивания после релиза удвоились, а новые issues писали десятки разных людей, спрашивавших, как восстанавливать сессии на мобильных.
Редактор пишет о теме второй библиотеки, восстановлении сессий на мобильных, а о первой не упоминает. Число звёзд было самым громким на странице и наименее информативным.
Чего эта статья не может сказать
Она не может сказать, покупал ли конкретный репозиторий звёзды: исследование фальшивых звёзд сообщает о подозреваемых кампаниях, найденных классификатором, и его авторы признают, что возможны ложные срабатывания [3]. Она не даёт порога, с которого рост звёзд становится подозрительным, и доли скачиваний, приходящейся на автоматику: таких цифр в источниках не нашлось. Исследование запусков охватывает один форум и один вид инструментов [5]. Независимого исследования, которое показало бы, что любой из этих сигналов опережает более широкое внедрение на измеренную величину, не найдено. Шесть шагов экспериментально не проверялись. Пример выдуман.
Как сделана эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверено |
|---|---|---|---|
| Исследование | Собрал источники о звёздах GitHub, счётчиках скачиваний пакетов и платформах разработчиков в заметки | Выбрал вопрос и источники, на которые опираться | Цифры и цитаты сверены с GitHub Docs, документацией npm и Python Packaging, документацией Hugging Face и работами [1]–[11] |
| Черновик | Написал первый черновик по заметкам | Отредактировал текст, шаги и пример | Отдельное ревью сверило цифры и утверждения с источниками |
| Изображения | Создал обложку в стиле фотографии | Выбрал иллюстрацию; сам разработал поясняющие схемы | Помечено как созданное ИИ в строке раскрытия и в альтернативном тексте |
| Не делал ИИ | — | Решение о публикации и ответственность за текст | — |
Конфликт интересов: нет. У автора нет коммерческих отношений с GitHub, npm, Python Software Foundation, Hugging Face, Stack Overflow или названными исследователями; библиотеки в примере вымышленные.
Ответственный за статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Пометки: официальный (страница самой организации), исследование (работа, прочитанная по официальной аннотации или полному тексту).
- GitHub Docs, "Saving repositories with stars". https://docs.github.com/en/get-started/exploring-projects-on-github/saving-repositories-with-stars Официальный.
- GitHub Docs, "GitHub Acceptable Use Policies" (section on spam and inauthentic activity). https://docs.github.com/en/site-policy/acceptable-use-policies/github-acceptable-use-policies Официальный.
- Hao He, Haoqin Yang, Philipp Burckhardt, Alexandros Kapravelos, Bogdan Vasilescu, Christian Kästner, "Six Million (Suspected) Fake Stars in GitHub: A Growing Spiral of Popularity Contests, Spams, and Malware", arXiv:2412.13459 (v2, 6 September 2025). https://arxiv.org/abs/2412.13459 Исследование (препринт), полный текст.
- Hudson Borges, Marco Tulio Valente, "What's in a GitHub Star? Understanding Repository Starring Practices in a Social Coding Platform", Journal of Systems and Software 146 (2018), arXiv:1811.07643. https://arxiv.org/abs/1811.07643 Исследование, официальная аннотация.
- Obada Kraishan, "Launch-Day Diffusion: Tracking Hacker News Impact on GitHub Stars for AI Tools", arXiv:2511.04453 (2025). https://arxiv.org/abs/2511.04453 Исследование (препринт), официальная аннотация.
- npm registry documentation, "download-counts". https://github.com/npm/registry/blob/main/docs/download-counts.md Официальный.
- npm blog, "numeric precision matters: how npm download counts work" (22 July 2014). https://blog.npmjs.org/post/92574016600/numeric-precision-matters-how-npm-download-counts-work Официальный.
- Python Packaging User Guide, "Analyzing PyPI package downloads". https://packaging.python.org/en/latest/guides/analyzing-pypi-package-downloads/ Официальный.
- Hugging Face Hub documentation, "Models Download Stats". https://huggingface.co/docs/hub/models-download-stats Официальный.
- GitHub Docs, "About the dependency graph" (dependents and the "Used by" section). https://docs.github.com/en/code-security/supply-chain-security/understanding-your-software-supply-chain/about-the-dependency-graph Официальный.
- Gordon Burtch, Dokyun Lee, Zhichen Chen, "The consequences of generative AI for online knowledge communities", Scientific Reports 14, 10413 (2024). https://pmc.ncbi.nlm.nih.gov/articles/PMC11074245/ Исследование, полный текст.











