
Инструменты ИИ помогли собрать исследование и написать первый черновик этой статьи. Я отредактировал текст и сверил каждую цитату со страницей-источником из списка в конце. Обложка создана ИИ. Подробности в конце статьи.
У любого, кто неделю понаблюдал за игровым сообществом, появляется список. Кто-то спрашивает, можно ли после патча всё ещё пройти квест. Другой хочет знать, стоит ли покупка своих денег. Родитель интересуется, безопасна ли игра для девятилетнего ребёнка. Вернувшийся игрок спрашивает, что изменилось с тех пор, как он ушёл. Список быстро растёт, и возникает соблазн отвечать на самые громкие вопросы по одному.
Так получается груда статей, а не издание. Карта превращает список вопросов в план: она говорит, кто спрашивает, что он пытается сделать и какой материал ему отвечает. Без неё на один и тот же вопрос отвечают трижды под тремя заголовками, а очевидный пробел остаётся открытым, потому что в месте, где вы смотрели, о нём никто не спросил.
В статье описан один способ построить такую карту для информационного сайта об играх, из трёх слоёв: читатель, класс вопроса и материал. Это рабочий метод, а не доказанный. В последних разделах сказано, чего он сообщить не может.
Почему списка вопросов недостаточно
Вопрос — это поверхность. «Стоит ли покупать?» может задать человек, ни разу не касавшийся жанра, фанат, решающий насчёт дополнения, или родитель, выбирающий подарок. Слова одни и те же; ответ, который поможет каждому, разный.
Бывает и наоборот. «С чего начать?», «что нужно знать новичку?» и «не поздно ли присоединяться?» — три вопроса с одной и той же задачей. Если отвечать на них по отдельности, получатся три тонкие статьи, которые повторяют друг друга и борются за одного и того же читателя.
Поэтому первая работа — не писать. Нужно решить, что считать одним и тем же вопросом, а что разными, и записать это решение, чтобы следующий человек в команде принимал его так же. Рекомендации Google для владельцев сайтов указывают на ту же цель с другой стороны. Среди вопросов для самооценки там есть такой: после прочтения материала человек уходит, «чувствуя, что узнал достаточно о теме, чтобы достичь своей цели» [1]. Цель — свойство ситуации читателя, а не формулировки вопроса.
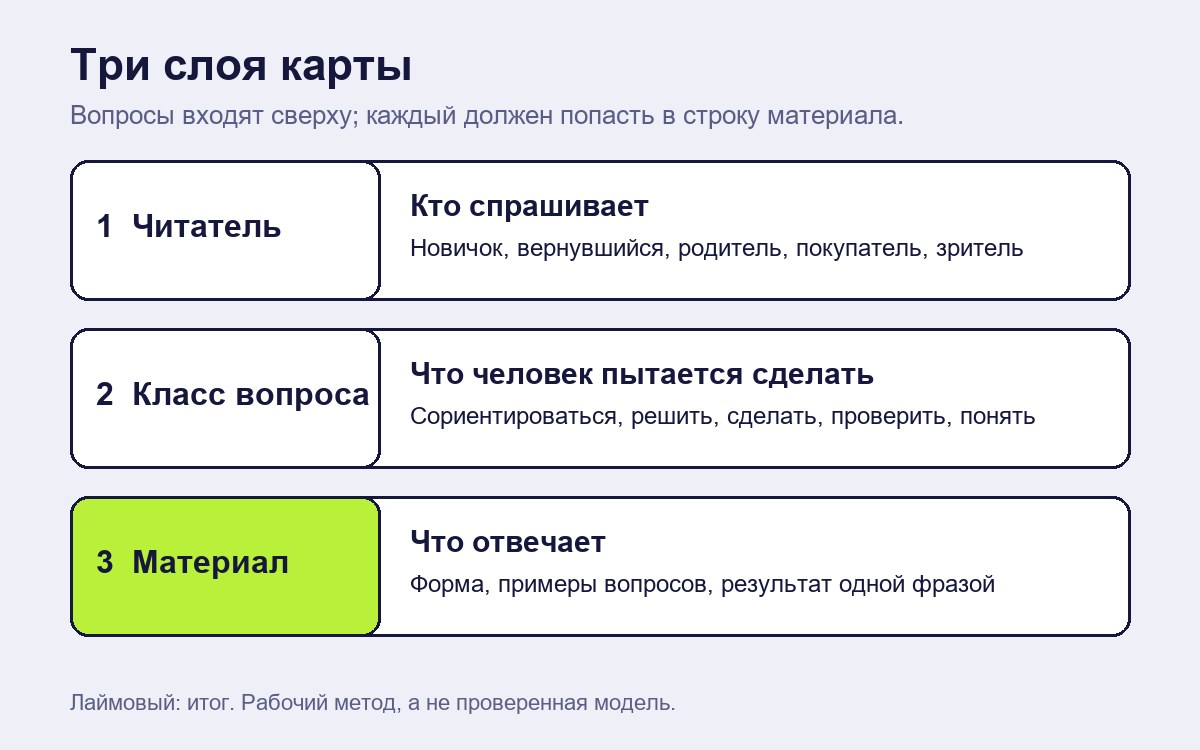
Слой первый: читатель
Начните с короткого списка типов читателей, определённых по ситуации, а не по демографии. Для сайта об играх рабочий набор может быть таким:
- Новичок, который не знает терминов и решает, с чего начать.
- Вернувшийся игрок, который когда-то знал игру и хочет понять, что изменилось.
- Занятой родитель, который не играет и ему нужен быстрый и безопасный ответ.
- Покупатель, который сравнивает игру, платформу или покупку.
- Зритель, который смотрит стримы или видео и хочет понять увиденное.
- Автор контента, который пишет, стримит или делает гайды и нуждается в справочном материале.
Список намеренно короткий. Шести типов хватает, чтобы держать читателя в уме при письме; двадцать превращаются в таблицу, в которую никто не заглядывает. Проверка типа практическая: меняет ли знание о нём начало статьи, лексику или длину ответа? Если нет — объедините его с соседним.
Тип читателя — это гипотеза о том, кто чаще спрашивает, а не факт об отдельном человеке. Относитесь к нему как к метке на вопросе, которая помогает выбрать тон и точку входа, и отказывайтесь от метки или меняйте её, когда данные не согласны.
Слой второй: класс вопроса
Второй слой — то, что читатель пытается сделать. Классы вопросов — это задачи, например:
- Сориентироваться: что это и для меня ли это?
- Решить: покупать, играть или переходить?
- Сделать: как пройти этот шаг, устранить проблему, настроить?
- Проверить: это безопасно, актуально, разрешено, верно?
- Понять: почему это работает так, что изменилось, что означает этот термин?
Классов гораздо меньше, чем вопросов. Несколько сотен сырых вопросов обычно сворачиваются в горстку классов, как только вы перестаёте читать формулировки и начинаете читать задачу.
Как построить классы, не выдумывая их? В исследованиях пользовательского опыта для такой группировки есть стандартный метод: сортировка карточек. Nielsen Norman Group определяет её как «метод исследования, в котором участники раскладывают по группам отдельно подписанные карточки» [2]. При открытой сортировке «пользователи сами создают группы без заранее заданных категорий»; при закрытой «пользователям дают готовые категории и просят разложить отдельные карточки по ним» [2]. Тот же источник советует «не менее 15 участников» для качественного исследования и «не менее 30–50 участников» для количественного [2].
Эти числа относятся к исследованиям того, как люди группируют информацию, а редакция, сортирующая вопросы, такого исследования не проводит. Но логика переносится. Сначала проведите открытую сортировку, чтобы классы вышли из вопросов, а не из ваших предположений. Затем закрытую сортировку с готовыми классами, чтобы убедиться, что второй человек кладёт тот же вопрос на то же место. Если двое расходятся в том, куда относится вопрос, определения классов ещё недостаточно ясны.
Слой третий: материал
Третий слой — текст, который отвечает на класс вопроса для типа читателя. Полезный ход — назвать форму раньше темы. «Проверить» от родителя требует короткого прямого ответа с вердиктом в начале. «Понять» от вернувшегося игрока требует сводки в духе списка изменений. «Сделать» требует шагов.
Записи материала в карте достаточно пяти пунктов:
- тип или типы читателей, которым он служит,
- класс вопроса,
- два-три примера вопросов словами самих читателей,
- форма (короткий ответ, гайд, сравнение, справочник, пояснение),
- то единственное, что читатель должен суметь сделать или решить после прочтения.
Пятый пункт самый полезный. Он близок к проверке из рекомендаций Google: уходит ли читатель, «узнав достаточно о теме, чтобы достичь своей цели» [1]. Если не получается сформулировать это одной фразой, запись — тема, а не материал.
Карта — это таблица, а не схема
Карту такого рода лучше всего вести как простую таблицу: одна строка на материал и колонки для читателя, класса, примеров вопросов, формы и результата. Вторая таблица перечисляет каждый сырой вопрос со строкой, к которой он относится. Две таблицы позволяют провести четыре проверки:
- У каждого вопроса есть дом. Вопрос без строки либо вне охвата, и это нужно записать как решение, либо признак того, что не хватает строки.
- У каждой строки есть вопросы. Строка без реальных вопросов под ней — догадка, выданная за план.
- Две строки не отвечают на один вопрос для одного читателя. Если отвечают, объедините их или явно обозначьте различие.
- У каждого вопроса записано, откуда он взялся. Хватит одной колонки с источником, а почему, объясняет последний раздел перед ловушками.
Для этого не нужна специальная программа. Ценность в том, что решения становятся видимыми, и два редактора, или редактор и ИИ-помощник, пишущий черновик, получают совпадающие строки.
Рабочий пример (выдуманный)
Следующий пример вымышленный. Игра, вопросы и решения придуманы, чтобы показать метод.
Представьте небольшую фермерскую игру Hollow Orchard. Неделя чтения обсуждений в сообществе даёт список вопросов. Шесть из них:
- «Стоит ли Hollow Orchard своих денег, если у меня только час в день?»
- «Может ли мой 9-летний ребёнок играть онлайн с незнакомцами?»
- «Я остановился на летнем обновлении, что я пропустил?»
- «Как открыть теплицу?»
- «Нужен ли теплице старый ключ после патча?»
- «Чем отличается базовая игра от дополнения?»
Первичное разбиение по читателю и классу даёт:
| Вопрос (в сокращении) | Читатель | Класс |
|---|---|---|
| Стоит ли с часом в день? | Покупатель | Решить |
| Ребёнок 9 лет онлайн? | Родитель | Проверить |
| Что я пропустил с лета? | Вернувшийся игрок | Понять |
| Как открыть теплицу? | Новичок | Сделать |
| Ключ теплицы после патча? | Вернувшийся игрок | Проверить |
| Базовая игра или дополнение? | Покупатель | Решить |
Читая таблицу, редактор видит, что первая и последняя строки — одна и та же задача для одного и того же читателя, и объединяет их в один материал: короткий гид по покупке, где разобраны затраты времени и различие между базовой игрой и дополнением. Вопрос родителя становится отдельным коротким ответом, потому что у его читателя и его формы нет аналогов в списке. Два вопроса о теплице похожи, но различаются классом. Один — «Сделать», ему нужны шаги; другой — «Проверить», остаётся ли что-то в силе. Второй — кандидат на заметку внутри первого, и редактор записывает это решение, чтобы его не пересматривали каждую неделю.
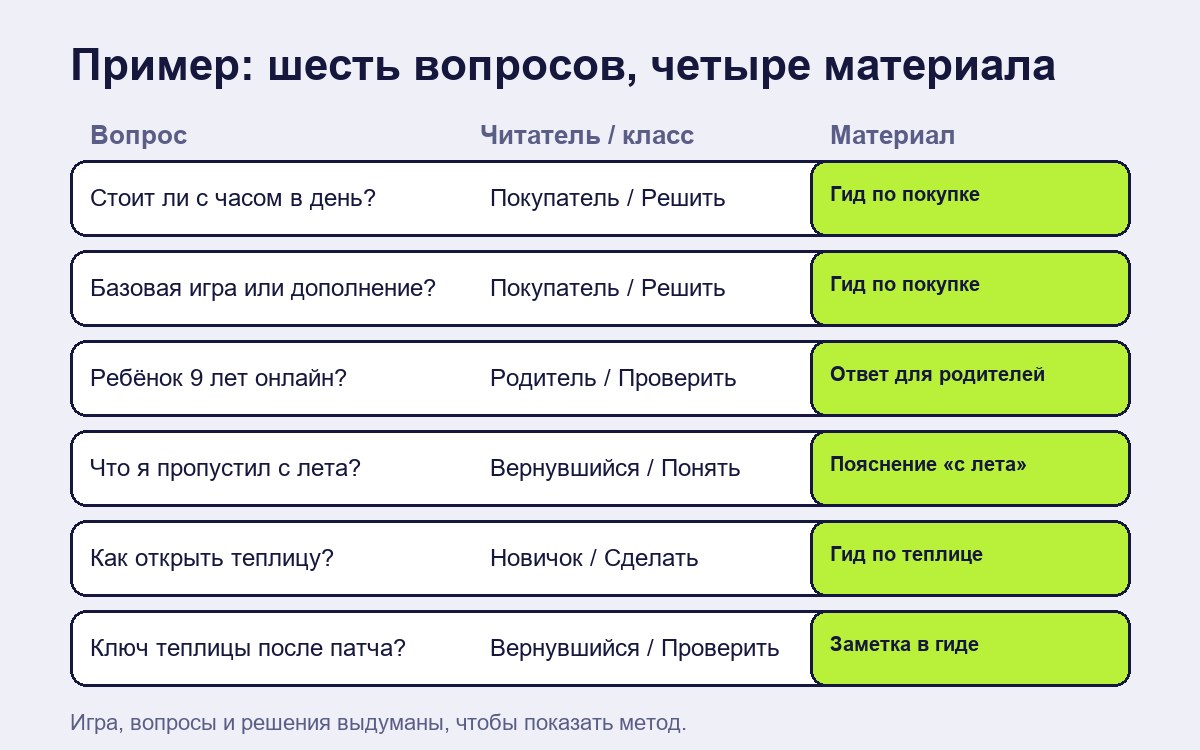
В итоге вместо шести статей четыре материала: гид по покупке, ответ о безопасности для родителей, пояснение «что изменилось с лета» и гид по теплице с заметкой о патче. У каждого есть читатель, класс, примеры вопросов, форма и результат одной фразой. Вопрос, у которого нет очевидного дома, попадает в список «отложенных» с указанием причины, а не втискивается в строку насильно.
Откуда берутся вопросы и как это влияет на карту
Карта хороша ровно настолько, насколько хороши места, где читали вопросы. Обсуждения показывают, о чём люди спрашивают друг друга. Поисковые данные показывают, что люди вводят в поисковик. Это разные выборки.
Google Search Console может показать запросы, по которым люди пришли на ваш сайт. Отчёт об эффективности определяет клики как «число переходов пользователя на ваш сайт из результатов поиска Google», показы — как «сколько раз ваш сайт появился в результатах поиска», а измерение «запросы» «группирует данные по поисковому запросу, который ввели пользователи» [3]. Для редакционной карты важны два ограничения. Данные охватывают только поиски, в которых ваш сайт уже появлялся, поэтому они не могут показать пробел в том, что вы пока не освещаете. И отчёт пропускает часть запросов: на справочной странице Google сказано, что «таблицы в отчётах об эффективности не включают редкие запросы, чтобы защитить конфиденциальность пользователей» [4]. Самые редкие и конкретные вопросы часто как раз то, что малому сайту нужнее всего увидеть, и именно их этот инструмент скрывает.
Это причина записывать происхождение каждого вопроса в дополнительной колонке таблицы. Карта, собранная целиком из одного сообщества, будет повторять привычки этого сообщества. Карта, где записано, откуда взят каждый вопрос, показывает, какие её части опираются на единственный источник.
Типичные ошибки
- Классы-темы. «Квесты», «Экономика» и «Обновления» — это полки, а не задачи. На одной полке оказываются два читателя с противоположными потребностями. Перепишите каждый класс как то, что читатель пытается сделать.
- Слишком много типов читателей. Если у каждого типа по одному вопросу, типы выполняют работу вопросов. Объединяйте, пока у каждого типа не станет несколько вопросов.
- Объединение по формулировке. Два вопроса с одинаковыми словами от разных читателей — две записи. Два вопроса с разными словами и одной задачей — одна.
- Считать карту законченной. Это гипотеза о вопросах, увиденных к настоящему моменту. Новые вопросы, которые не вписываются, — сигнал пересмотреть её.
Чего эта статья сообщить не может
Она не говорит, сколько людей задаёт каждый из этих вопросов. Карта показывает, какие бывают вопросы и как они связаны, а не насколько велика каждая группа. Она также не может утверждать, что эти шесть типов читателей — правильные шесть для вашей игры; это стартовый набор, который нужно менять по данным. Цифры о сортировке карточек взяты из исследований группировки информации и приводятся как ссылка на метод, а не как правило для редакций [2]. Я не нашёл опубликованного исследования, проверяющего именно эту трёхслойную карту на игровом сайте. Рабочий пример выдуман, а метод экспериментально не проверялся.
Как создавалась эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверялось |
|---|---|---|---|
| Исследование | Собрал рабочий метод из внутреннего исследовательского документа и нашёл подтверждающие источники по методу | Выбрал вопрос и источники, на которые опираться | Цитаты сверены со страницами из списка ниже [1]–[4] |
| Черновик | Написал первый черновик по заметкам | Отредактировал текст, структуру и рабочий пример | Отдельная проверка сопоставила цитаты и утверждения с источниками |
| Изображения | Сгенерировал обложку; написал скрипты, которые рисуют карточки и диаграммы по тексту статьи | Просмотрел каждое изображение и одобрил его | Помечено как созданное ИИ в строке раскрытия и в альтернативном тексте |
| Не делал ИИ | н/д | Решение о публикации и ответственность за текст | н/д |
Трёхслойная схема (читатель, класс вопроса, материал) взята из внутреннего рабочего документа Dapp.Expert и описана здесь как метод, а не как измеренный результат. Этот документ не публичный.
Конфликт интересов: нет. У автора нет коммерческих отношений с Google, Nielsen Norman Group и упомянутыми сайтами; игра в примере вымышлена.
Ответственный за статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Пометка: официальный (собственная страница организации).
- Google Search Central, «Creating helpful, reliable, people-first content». https://developers.google.com/search/docs/fundamentals/creating-helpful-content Официальный.
- Nielsen Norman Group, «Card Sorting: Uncover Users' Mental Models for Better Information Architecture». https://www.nngroup.com/articles/card-sorting-definition/ Официальный.
- Справка Google Search Console, отчёт об эффективности (Поиск), ответ 7576553. https://support.google.com/webmasters/answer/7576553 Официальный.
- Справка Google Search Console, «About Search Console data» (ответ 96568). https://support.google.com/webmasters/answer/96568 Официальный.











