
ИИ помогал собирать исследование и писать первый черновик этой статьи. Я отредактировал текст и сверил каждую цифру и цитату со страницей-источником из списка в конце. Обложка создана ИИ. Подробности в конце.
Когда вы ищете вопросы, о которых стоит писать, вы читаете то, что люди говорят публично: посты, ответы, ветки форумов, поисковые подсказки, собственную аналитику. Всё это приходит от людей, которые высказались, поискали или кликнули там, где вы можете это увидеть. Тех, кто молчал, пользовался другой платформой или искал так редко, что инструмент их скрыл, в данных нет. Их отсутствие не выглядит пробелом. Оно выглядит как аккуратный, уверенный график.
Это не повод не доверять публичным данным. Это повод задать каждому источнику ещё один вопрос: кто мог попасть в эти данные, а кто не мог? Честный ответ меняет то, что из них можно утверждать.
Это четвёртая часть «Радара интересов», серии о поиске вопросов, которые стоит исследовать. Часть 1 была о том, как отличить устойчивый тренд от короткого всплеска, часть 2 — о том, как поставить публичные поисковые тренды рядом с собственными поисковыми данными, часть 3 — о числах популярности у разработчиков, которые вводят в заблуждение. Эта часть о людях, которых эти числа не учитывают.
У каждого источника есть дверь
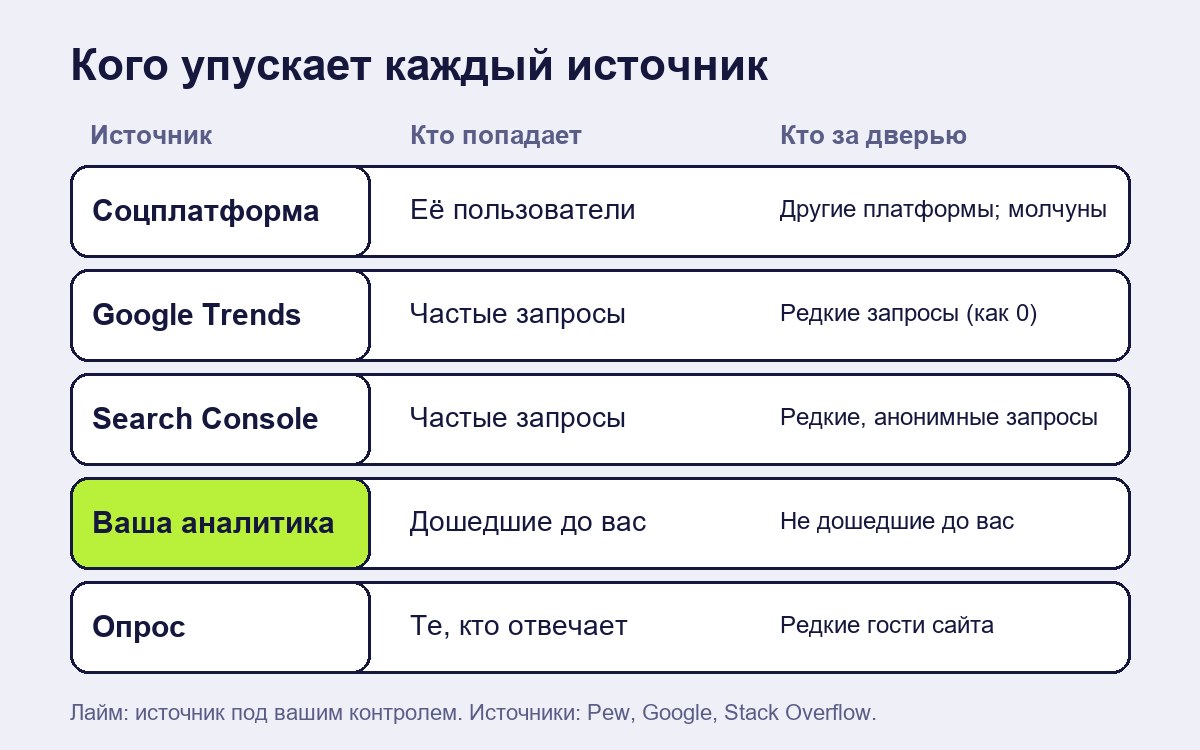
Сигнал доходит до вас, только если кто-то прошёл через дверь, чтобы его создать: завёл аккаунт, написал пост, искал достаточно часто, чтобы попасть в счёт, принял трекер. В таблице собрано то, что говорят документация и исследования, на которых построена эта статья, о дверях распространённых источников.
| Источник | Кто попадает | Кто или что остаётся за дверью |
|---|---|---|
| Социальная платформа | Пользователи этой платформы [1][2] | Все, кто ей не пользуется; большинство пользователей, которые редко пишут [1] |
| Google Trends | «Largely unfiltered sample of actual search requests» [7] | Редкие запросы, которые показываются как 0; повторные поиски одного человека за короткое время [7] |
| Запросы в Search Console | Запросы, которые вводит достаточно людей | Анонимизированные запросы, исключённые из строк таблицы [8] |
| Ваша веб-аналитика | Посетители, до которых ваш сайт уже дошёл | Все, кто так и не пришёл; строки с малым числом, которые GA4 может скрыть [9] |
| Опрос разработчиков | Те, кто на него отвечает | Разработчики, которые нечасто заходят на сайт-хозяин опроса [10] |
Дальше разберём эти двери по одной.
Пользователи платформы — не «публика»
Под публичным обсуждением обычно понимают одну-две платформы, а ни одна платформа не является срезом общества. Исследование Pew Research Center 2019 года о пользователях Twitter в США полезно как измерение, потому что оно сравнивало пользователей с населением в целом. На основе вероятностной панели взрослых американцев Pew сообщил, что медианному взрослому пользователю Twitter было 40 лет против 47 у медианного взрослого американца, что не менее степени бакалавра имели 42% пользователей Twitter против 31% населения, а с Демократической партией себя связывали или к ней склонялись 60% против 52% взрослых американцев [1]. Различия умеренные, а не крайние, и в этом суть: источник может выглядеть обычным и всё же склоняться сразу в нескольких направлениях.
Охват различается и по платформам, и по возрасту. В опросе Pew 5 511 взрослых американцев, проведённом с января по июнь 2026 года, 18% сказали, что пользуются X, а 25% — Reddit, против 31% у LinkedIn и 84% у YouTube. Среди взрослых 18–29 лет X пользуются 31%, среди тех, кому 65 и больше, — 7% [2]. Если ваши читатели не в основном американцы или не в основном на одной платформе, числа будут другими, а эти цифры описывают только взрослых американцев. Переносится сам вопрос: разговор на любой одной платформе — это разговор среди пользователей этой платформы.
Внутри платформы говорят немногие
Даже среди тех, кто есть на платформе, говорят неравномерно. Исследование Pew 2019 года показало, что 10% американских пользователей Twitter, пишущих больше всех, создавали 80% твитов американских пользователей, а медианный пользователь писал около двух твитов в месяц [1]. Сообщаемая смесь твитов была смесью шумного меньшинства, а не типичного пользователя.
Это старая закономерность. В 2006 году Якоб Нильсен описал её как правило 90-9-1: 90% пользователей — «читатели», которые читают, но не пишут, 9% пишут время от времени, а 1% «participate a lot and account for most contributions» [3]. Его цифры по Википедии были ещё резче: более 99% пользователей были читателями, а самые активные 1 000 человек, около 0,003% пользователей, сделали примерно две трети правок [3]. Статье два десятилетия, а её пропорции были оценкой того момента, а не законом. Считайте это формой проблемы и берите свежие данные платформ, когда можете их получить.
Если вы собираете вопросы из публичных веток, вы, таким образом, выбираете небольшую активную долю из уже отобранной группы. То, что волнует эту долю, может быть настоящими интересами. А может быть интересами людей со свободным временем, уверенностью и привычкой спорить публично.
О чём предупреждают исследователи
Исследователи, работающие с данными соцсетей, говорят об этом не первый год. В политическом форуме Science 2014 года Дерек Рутс и Юрген Пфеффер начинают с выборов в США 1948 года, когда заголовок газеты назвал не того победителя, потому что телефонные опросы «inadvertently undersampled» сторонников одного из кандидатов [4]. Затем они описывают распространённое допущение в исследованиях соцсетей: «that a large-enough sample of users will drown out noise introduced by peculiarities of the platform's population» [4]. Их ответ: «substantial population biases vary across different social media platforms», а «these sampling biases are rarely corrected for (if even acknowledged)» [4]. Одно из средств в их списке — показывать результаты более чем с одной платформы или из разнесённых по времени наборов данных одной платформы [4].
В аннотации статьи Зейнеп Туфекчи 2014 года перечислены родственные проблемы: чрезмерное внимание к одной платформе, Twitter; «sampling biases arising from selection by hashtags»; и «algorithmic invisibility», когда пользовательские практики вроде подтвитов или публикации скриншотов текста скрывают содержимое от простого поиска [5]. Если вы ищете на платформе ключевое слово, вы находите тех, кто его набрал.
Эстер Харгиттаи в статье 2015 года по данным опросов выяснила, что люди вступают в социальные сети не случайно: использование различается по возрасту, полу, расе и этничности, социально-экономическому положению, онлайн-опыту и интернет-навыкам, и это ограничивает, насколько можно обобщать выводы с этих сайтов [6].
Ни одна из этих работ не говорит, что данные соцсетей бесполезны. Они говорят, что размер не исправляет отбор: миллион постов от узкой группы всё равно остаётся узкой группой.
Когда людей скрывает сам инструмент
Некоторые слепые пятна встроены в аналитические инструменты, обычно ради приватности.
Google Trends показывает «a largely unfiltered sample of actual search requests», но «Trends only shows data for popular terms, so search terms with low volume appear as '0'» [7]. На той же странице сказано, что повторные поиски одного человека за короткий период удаляются, а поиски, сделанные собственными продуктами Google, исключаются [7]. Поэтому ноль в Trends означает «недостаточно искавших, чтобы показать», а не «никому это не нужно». Это та ситуация, о которой шла речь в части 2: исчезают именно узкие запросы.
Search Console работает по похожему правилу. В блоге Google Search Central анонимизированные запросы определены как «those that aren't issued by more than a few dozen users over a two-to-three month period» [8]. Они не попадают в таблицы, но входят в итоги на графиках, если не фильтровать по запросу [8]. Если сложить видимые строки запросов, итог может оказаться ниже общего, а недостающее — это как раз редкие, конкретные вопросы, нужные проекту по исследованию аудитории.
Google Analytics 4 применяет пороги данных, скрывающие данные отчёта, когда они могут раскрыть сведения об отдельных пользователях, особенно в демографии и на узких диапазонах дат. Пороги задаются системой, и менять их нельзя [9]. А ваша аналитика по построению описывает только тех, кто вас нашёл. Тот, кому нужна была ваша тема и кто так и не дошёл до вашего сайта, не появится ни в одном отчёте, который вы можете открыть.
Общий урок: когда инструмент убирает малые группы, он скрывает людей с самыми нетипичными вопросами. Для исследования, нацеленного на поиск вопросов, на которые ещё нет ответа, это существенная потеря.
Даже у хорошего опроса есть дверь
Опросы могут дойти до тех, кто никогда не пишет, но тоже отбирают. Опрос разработчиков Stack Overflow 2025 года сообщает о «over 49,000+ responses from 177 countries» [10]. Это большая выборка, но страница результатов показывает, что на США приходится 20,4% респондентов, затем Германия с 8,6% и Индия с 7,2% [10], и что 82% респондентов заходят на сайт не реже нескольких раз в месяц [10]. У разработчика, который редко пользуется Stack Overflow или работает в стране с малым числом респондентов, меньше шансов быть учтённым. Опрос ценен. Его выборка — «люди, которые отвечают на опрос с этого сайта», и читать его лучше именно так.
Короткий метод: запишите, кого не хватает
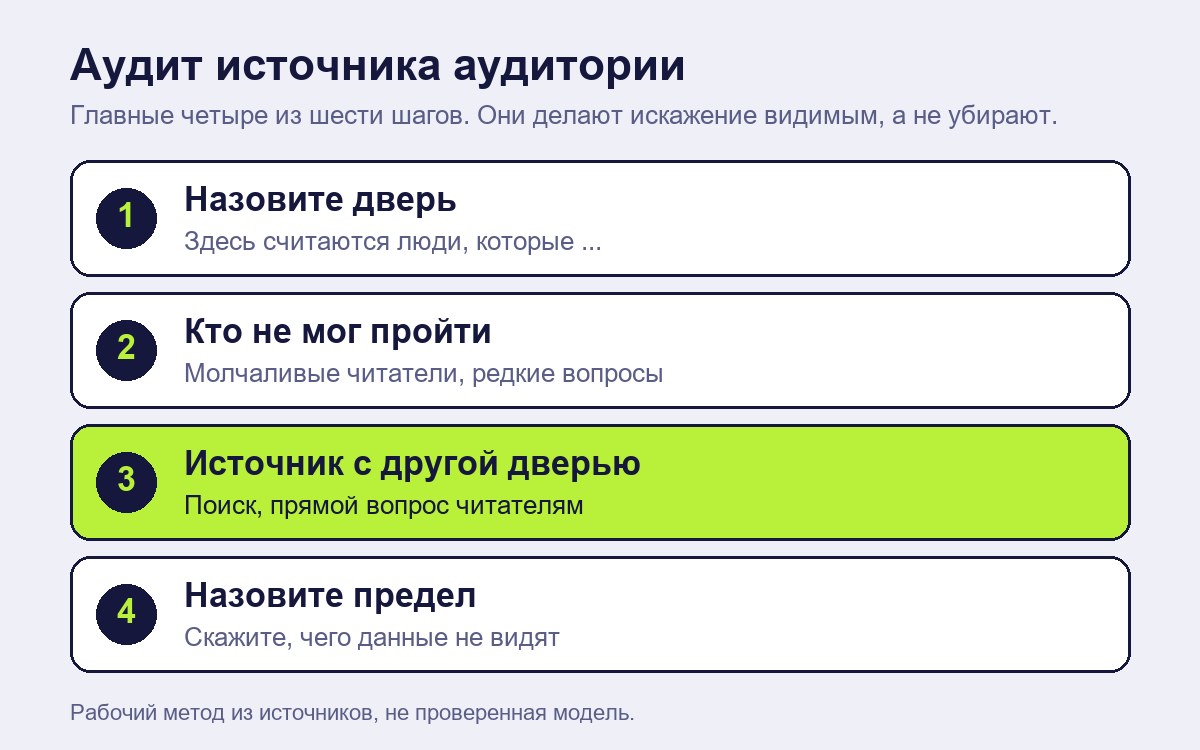
Шаги ниже — рабочий метод, построенный на перечисленных источниках, а не проверенная модель. Они не устраняют искажение. Они держат его на виду, чтобы вы не утверждали лишнего.
- Назовите дверь. Для каждого источника напишите одно предложение: «Здесь считаются люди, которые ___». Например, «люди, пишущие об этом в X» или «люди, которые ищут достаточно часто, чтобы пройти порог Trends» [7].
- Назовите, кто не мог пройти. Перечислите две-три группы, которые входят в ваших предполагаемых читателей, но, вероятно, не входят в источник: люди на других платформах, люди, которые читают, но не пишут [1][3], люди с редкими вопросами [8], люди, так и не дошедшие до вашего сайта [9].
- Сравните с эталоном, где он есть. Если вы знаете возрастной диапазон, привычки по платформам или страны ваших читателей, сверьте их с цифрами вроде данных Pew [1][2]. Где эталона нет, пишите «неизвестно», а не гадайте.
- Добавьте источник с другой дверью. Сопоставьте источник публичных обсуждений с таким, где писать не нужно: поисковые данные, прямой вопрос читателям или короткий опрос, который вы отправляете сами. Рутс и Пфеффер говорят то же о платформах: показывайте результаты более чем с одной [4]. Согласие источников с разными дверями сильнее объёма в одном.
- Не читайте молчание как отсутствие. Тема, которую никто не упоминает в ваших данных, может быть не упомянута потому, что её аудитории там нет. Помечайте её «не наблюдалось», а не «не нужно».
- Назовите предел в самой статье. Одна строка вроде «Здесь использованы публичные посты и запросы из Search Console; читатели, которые не пишут, не охвачены» говорит читателю, о чём вывод.
Пример (вымышленный)
Редактор, каналы и каждое число в этом разделе выдуманы, чтобы показать метод.
Редактор планирует руководство по защите криптокошельков. Читая публичную платформу, она видит, что большинство веток о безопасности кошельков длинные и технические: аппаратные кошельки, схемы подписи, разделение seed-фразы. Она готова писать продвинутое руководство.
Она проходит шаги. Дверь её источника — «люди, пишущие об этом на одной платформе», и по исследованиям выше она ожидает, что небольшая активная доля пишет большую часть прочитанного [1][3]. Кто не мог пройти? Новички, которые читают и не пишут. Люди, которые спрашивают поисковик, а не сообщество. Она открывает Search Console и видит, что за трёхмесячное окно видимые строки запросов дают примерно половину кликов с графика, остальное скрыто как анонимизированные запросы [8]. Эти запросы она увидеть не может. Но в видимых строках самая частая формулировка простая: «как сделать резервную копию кошелька», «что будет, если я потеряю телефон».
Она также отправляет в рассылку форму из одного вопроса: «Что одно в безопасности кошельков вам непонятно?» Ответы тоже в основном простые. Два источника с разными дверями указывают в одну сторону, и оба отличаются от публичных веток.
Она сначала пишет руководство для новичков и добавляет в начале строку: «Руководство опирается на публичные посты, запросы Search Console и ответы наших читателей; люди, которые никогда не заходили на этот сайт, не охвачены». Продвинутое руководство остаётся в списке с пометкой, что его свидетельства получены с одной платформы.
Числа выдуманы. Важен порядок работы: сказать, кто есть в данных, найти источник с другой дверью и сказать, что остаётся не охваченным.
Чего эта статья не может сказать
Она не может сказать, кого не хватает в вашей аудитории. Это зависит от ваших читателей, ваших платформ и вашей темы, и никакая общая цифра не заменит поиска. Цифры Pew описывают взрослых американцев и, для исследования Twitter 2019 года, пользователей того времени; пропорции Нильсена 2006 года — старая оценка; результаты Stack Overflow взяты со страницы опроса, а не из исследования репрезентативности его респондентов. Я не нашёл измеренной независимой оценки того, насколько велико искажение для крипто- или разработческих сообществ, а шесть шагов экспериментально не проверялись. Статью Харгиттаи 2015 года я читал только по аннотации. Пример выдуман.
Как сделана эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверено |
|---|---|---|---|
| Исследование | Собрал и кратко изложил источники об искажениях платформ, неравенстве участия и ограничениях данных аналитики | Выбрал вопрос и источники, на которые опираться | Цифры и цитаты сверены со страницами Pew, Nielsen Norman Group, Google, arXiv, Science и Stack Overflow [1]–[10] |
| Черновик | Написал первый черновик по заметкам | Отредактировал текст, шаги и пример | Отдельное ревью сверило цифры и утверждения с источниками |
| Изображения | Создал обложку в стиле японской гравюры (из библиотеки обложек Dapp.Expert) | Выбрал иллюстрацию и содержание схем; схемы построены кодом | Помечено как созданное ИИ в строке раскрытия и в альтернативном тексте |
| Не делал ИИ | — | Решение о публикации и ответственность за текст | — |
Конфликт интересов: нет. У автора нет коммерческих отношений с Pew Research Center, Nielsen Norman Group, Google, Stack Overflow или названными исследователями; редактор и цифры в примере вымышлены.
Ответственный за статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Пометки: официальный (страница самой организации), исследование (работа, прочитанная по официальной аннотации или полному тексту).
- Pew Research Center, "Sizing Up Twitter Users" (24 April 2019). https://www.pewresearch.org/internet/2019/04/24/sizing-up-twitter-users/ Официальный, полный текст.
- Pew Research Center, "Social Media Fact Sheet" (National Public Opinion Reference Survey, 5,511 US adults, 30 January to 18 June 2026). https://www.pewresearch.org/internet/fact-sheet/social-media/ Официальный.
- Jakob Nielsen, "The 90-9-1 Rule for Participation Inequality in Social Media and Online Communities", Nielsen Norman Group (8 October 2006). https://www.nngroup.com/articles/participation-inequality/ Официальный.
- Derek Ruths and Jürgen Pfeffer, "Social media for large studies of behavior", Science 346(6213), 1063–1064 (28 November 2014). https://doi.org/10.1126/science.1257756 Исследование, полный текст (копия PDF издателя).
- Zeynep Tufekci, "Big Questions for Social Media Big Data: Representativeness, Validity and Other Methodological Pitfalls", ICWSM 2014, arXiv:1403.7400. https://arxiv.org/abs/1403.7400 Исследование, официальная аннотация.
- Eszter Hargittai, "Is Bigger Always Better? Potential Biases of Big Data Derived from Social Network Sites", The ANNALS of the American Academy of Political and Social Science 659(1), 63–76 (2015). https://doi.org/10.1177/0002716215570866 Исследование, аннотация по записи RePEc.
- Google Trends Help, "FAQ about Google Trends data". https://support.google.com/trends/answer/4365533 Официальный.
- Google Search Central Blog, "A deep dive into Search Console performance data filtering and limits" (19 October 2022). https://developers.google.com/search/blog/2022/10/performance-data-deep-dive Официальный.
- Google Analytics Help, "About data thresholds". https://support.google.com/analytics/answer/9383630 Официальный.
- Stack Overflow, "2025 Developer Survey". https://survey.stackoverflow.co/2025/ Официальный.











