
ИИ-инструменты помогли собрать материалы и написать первый черновик этой статьи. Я отредактировал текст и сверил каждую цифру и цитату со страницей-источником из списка в конце. Обложка создана ИИ. Подробности в конце.
Вы тратите полдня на то, чтобы собрать вопросы игроков одной игры: ветки форумов, ответы под видео, вопросы в чатах сообществ. В итоге у вас таблица на сто строк. Сто — приятное число, и так и тянет записать в плане: «игроки явно хотят это знать».
Таблица действительно подтверждает некоторое утверждение. Только не это. Список найденных вопросов — запись того, что вам удалось найти, а не измерение того, сколько людей хотят получить ответ. Их путают, потому что строки похожи на спрос: за каждой стоит реальный человек с реальным вопросом.
Это седьмая часть «Радара интересов» — серии о том, как находить вопросы, достойные исследования. Прежние части разбирали тренды и всплески, сочетание публичных трендов с вашими данными поиска, обманчивые сигналы разработчиков и тех, кого не хватает в исследованиях аудитории (часть 4). Здесь тема уже: что сто найденных вопросов могут и не могут сказать, на примере вопросов игроков об играх.
Три вещи, которыми сто строк не являются
Это не число людей. Один человек может задать один и тот же вопрос в трёх местах, а десять человек — в десяти разных формулировках. Прежде чем считать строки, вы решаете, какие из них «один и тот же вопрос». Это решение двигает итог сильнее, чем любые реальные изменения в аудитории.
Это не число поисковых запросов. Вопрос на форуме — это пост. Поисковый запрос — это строка, введённая в поисковик. Человек, написавший вопрос, мог сначала поискать и ничего не найти, и это само по себе информативно, но значит, что вопрос на форуме и поисковый спрос — два разных события с неизвестным соотношением между ними.
Это не случайная выборка. Вы нашли эти строки определёнными инструментами, фразами и в определённых местах. Кто-то другой, с другими фразами или в других местах, собрал бы другую сотню. В этом главная проблема, и следующий раздел разбирает её подробно.
Откуда взялась сотня
У каждого способа сбора есть своя форма. Три распространённых, с документированными ограничениями:
- Поиск социальной платформы. Недавний поиск в X охватывает «последние 7 дней»; более глубокий доступ даёт полнотекстовый поиск по архиву, который «доступен клиентам с оплатой по факту использования и Enterprise» [5]. Сто вопросов из недавнего поиска — это сто вопросов за одну неделю, а в неделю могут попасть обновление игры, видео стримера или патч, из-за которого один вопрос стал необычно частым.
- Ваши собственные ключевые слова. Вы найдёте только вопросы, содержащие слова, которые вам пришло в голову набрать. Игроки описывают проблему своими словами, и они часто не совпадают с вашими.
- Одно сообщество. Рутс и Пфеффер в политическом форуме журнала Science об изучении поведения через соцсети описывают распространённое допущение, что «достаточно большая выборка пользователей заглушит шум, вносимый особенностями аудитории платформы», и отвечают, что «существенные смещения в составе аудитории различаются на разных социальных платформах» [4]. Они писали об исследованиях целых популяций, а не о редакционном планировании, но логика переносится: больше строк из одного места не убирает смещение этого места, а лишь делает его вид обоснованнее.
О том, кого сбор оставляет за кадром — игроков, которые не пишут и не ищут на вашем языке, — речь в части 4; здесь важно лишь, что ни одна строка таблицы не говорит, сколько их.
Почему поисковый спрос выглядит иначе, чем список вопросов
Даже если бы вы могли идеально сосчитать запросы, список вопросов с ними бы не совпал: у поискового поведения «длинный хвост». В 2019 году Google сообщила, что среди всех запросов, которые она видит каждый день, «15 процентов — те, которых мы раньше не видели» [3]. Ahrefs сообщает, что ключевые слова с менее чем 10 запросами в месяц «составляют почти 93%» её базы ключевых слов по США [6]. Это собственная база вендора, и методика не публична, так что считайте это указанием на форму распределения, а не точной цифрой. Но форма понятна и так: несколько формулировок ищут часто, а очень многие — редко.
Для того, кто собирает вопросы, отсюда два следствия.
Во-первых, найденные вопросы смещены в сторону заметных. Вопрос, который живёт на странице форума или в поисковой подсказке, — это вопрос, который кто-то проиндексировал. Редкая формулировка, которую тысячи людей набирают по одному разу, не оставляет строки.
Во-вторых, публичные инструменты не видят дна хвоста. Google Trends говорит прямо: «используется только выборка поисковых запросов Google», числа «приводятся к шкале от 0 до 100», а «Trends показывает данные только по популярным запросам, поэтому запросы с малым объёмом отображаются как „0“» [1]. Search Console не включает в таблицы так называемые анонимизированные запросы — те, «которые не вводили больше нескольких десятков пользователей за два-три месяца», — «чтобы защитить приватность пользователя, задавшего запрос» [2]. Google Ads помечает ключевые слова, у которых «очень мало или совсем нет истории поиска», как слова с низким объёмом поиска и не пускает их в аукцион [7]. Во всех случаях вопрос, который был бы важен, наберись он у тысячи разных людей по разу, невидим или округляется до нуля в инструменте, которым вы стали бы это проверять.
Так что сто конкретных вопросов могут описывать длинный хвост, который не подтвердит ни один инструмент. Это не делает их бесполезными. Это делает их доказательством другого рода.
Что сто вопросов могут честно показать
Список найденных вопросов хорош в четырёх вещах:
- Словарь. Слова, которые игроки действительно используют, — часто не те, что в руководстве или списке ключевых слов.
- Типы потребностей. После группировки видно, о чём в основном спрашивают: «как это сделать», «стоит ли это покупать», «почему это сломалось» или «что изменилось». Такое соотношение подсказывает, какой формы статья на них ответит.
- Пробелы. Вопросы, на которые ответы неверны, противоречивы или отсутствуют, показывают, где точная страница была бы новой.
- Темы-кандидаты. Каждая группа — гипотеза: «людям нужно это знать». Для гипотез список и нужен.
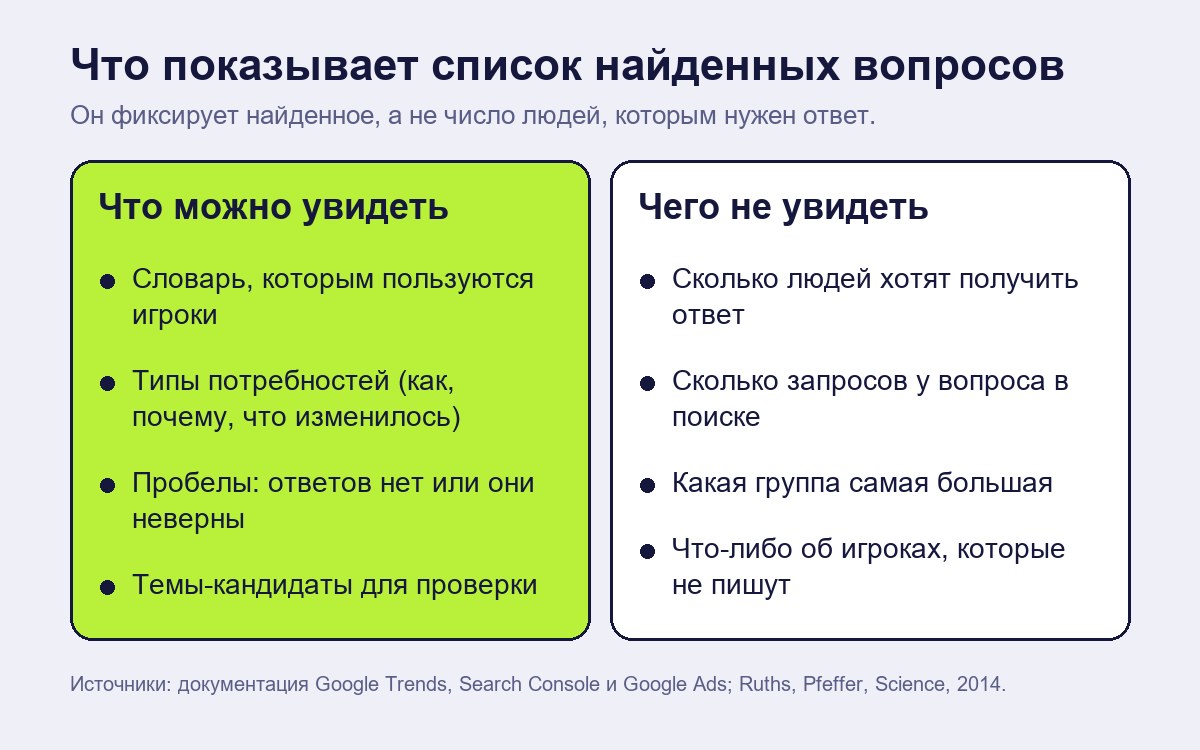
Чего он не может — ранжировать эти гипотезы по размеру. Группа из двадцати строк не обязательно больше группы из трёх. Возможно, её просто проще найти.
Есть и простое статистическое ограничение. Если бы сто строк были настоящей случайной выборкой аудитории — а они ею не являются, — доля, измеренная по ним, имела бы погрешность около ±10 процентных пунктов при 95% доверии в худшем случае (1,96 × √(0,5 × 0,5 / 100) ≈ 0,098; это стандартная формула для доли и мой собственный расчёт, а не цифра из источников выше). «Тридцать процентов вопросов — про крафт» значило бы тогда где-то от 20% до 40%. Поскольку строки не случайны, реальная неопределённость больше, и числом её не записать.
От списка к оценке: пять ступеней
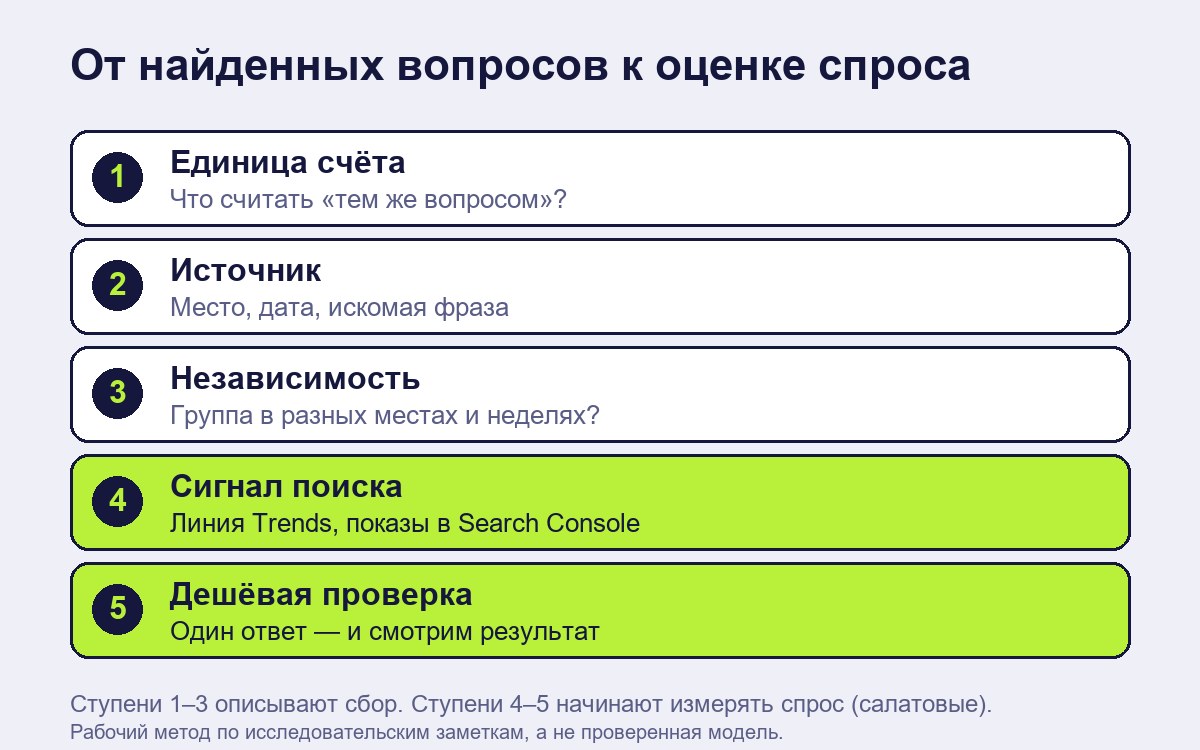
Шаги ниже — рабочий метод по материалам исследований для этой серии, а не проверенная модель. Каждая ступень добавляет вид доказательств, которого в списке нет. Прекращайте подъём, когда доказательств хватает для вашего решения.
- Зафиксируйте единицу счёта. Напишите правило «того же вопроса» до подсчёта. Например: та же потребность, та же игра и версия, любая формулировка. Считайте группы, а не строки, и сохраните правило, чтобы следующий сбор мог ему следовать.
- Записывайте, откуда пришла каждая строка. Место, дата, искомая фраза. Достаточно столбца с тремя-четырьмя значениями. Если большинство строк из одного источника или одной недели, скажите об этом рядом с любым числом.
- Проверьте независимость. Группа, которая встречается в нескольких не связанных местах и в разные недели, сильнее группы со множеством строк из одной ветки. Ответы в одной ветке не независимы друг от друга.
- Добавьте сигнал, измеряющий поиск. Посмотрите, существует ли тема как поисковый запрос вообще. Google Trends даёт относительную линию для запросов, достаточно популярных, чтобы появиться [1]. Если у вас есть сайт, Search Console показывает, как часто он появлялся по связанным запросам; её справка определяет показ как «сколько раз ваш сайт появился в результатах поиска» [8] — это не число людей и само по себе не число поисковых запросов. Как совместить эти два источника, разбирает часть 2 серии. Любой из них может вернуть пустой результат на узкий вопрос, и пустой результат не доказывает отсутствие спроса [1][2].
- Проведите дешёвую проверку. Опубликуйте короткий точный ответ на одну группу и несколько недель смотрите, что он даёт: показы в поиске, визиты, ссылаются ли на ответ. Это единственная ступень, которая измеряет спрос на ваш ответ, а не интерес к теме.
Если дальше второй ступени продвинуться не удаётся, назовите результат тем, что он есть: список тем-кандидатов из ограниченного сбора, а не оценка спроса.
Разобранный пример (вымышленный)
Игра, вопросы и цифры в этом разделе выдуманы, чтобы показать метод.
Редактор пишет о воображаемой фермерской игре Moss Valley. За один день он собирает 100 вопросов. Шестьдесят два — о том, почему в теплице перестают расти культуры. Одиннадцать — о торговле. Остальные разрознены. Запись в плане гласит: «Рост в теплице — самый большой спрос».
Он поднимается по лестнице. Ступень 1: шестьдесят две строки после группировки оказываются девятью разными потребностями; большую часть объясняет ошибка конкретной версии. Ступень 2: пятьдесят четыре из шестидесяти двух — из двух веток форума, открытых через неделю после патча. Ступень 3: вне этих двух веток вопросы о теплице за весь месяц встречаются в четырёх местах — с обычной для игры частотой. Ступень 4: связанный запрос появляется в Trends лишь коротким всплеском в неделю патча, а у сайта редактора слишком мало истории поиска, чтобы что-то сказать. Ступень 5: редактор публикует короткий ответ об ошибке патча и отдельно — статью о торговле, у которой было всего одиннадцать строк, но из шести мест за три месяца.
Через месяц статья о торговле даёт стабильные показы в поиске; заметка об ошибке патча дала всплеск и угасла. Редактор делает вывод: рост в теплице был настоящим, но временным вопросом, а одиннадцать строк про торговлю описывали постоянный. Счёт строк указывал не туда.
Чего эта статья вам не скажет
Она не скажет, сколько запросов получает конкретный игровой вопрос, и не назовёт число строк, которого «достаточно». Ни один источник такого правила не нашёл, а цифра 93% взята из базы одного вендора [6]. Погрешность — учебный расчёт для случайных выборок, к собранным вами строкам он не применим. Работа Рутса и Пфеффера касается исследований по данным соцсетей 2014 года, а правила доступа платформ с тех пор изменились; я беру из неё логику смещения, а не детали какой-либо платформы [4]. Пять ступеней экспериментально не проверялись. Разобранный пример выдуман.
Как сделана эта статья
| Задача | Что сделал ИИ | Что сделал человек | Как проверено |
|---|---|---|---|
| Исследование | Собрал источники об ограничениях поисковых данных и смещении выборки в исследовательские заметки | Выбрал вопрос и источники, на которые опираться | Цифры и цитаты сверены со страницами из списка [1]–[8] |
| Черновик | Написал первый черновик по заметкам | Отредактировал текст, пять ступеней и разобранный пример | Отдельное ревью сверило цифры и утверждения с источниками |
| Изображения | Сгенерировал обложку в стиле японской гравюры на дереве (из библиотеки обложек Dapp.Expert) | Выбрал иллюстрацию и содержание схем; схемы построены кодом | Помечено как созданное ИИ в строке раскрытия и в альтернативном тексте |
| Без участия ИИ | — | Решение о публикации и ответственность за текст | — |
Конфликт интересов: нет. У автора нет коммерческих отношений с Google, Ahrefs, X или названными исследователями; игра в примере вымышлена.
Ответственный за эту статью: Дмитрий Ластовка, автор. Исправления: форма обратной связи.
Источники
Пометки: official (собственная страница организации), vendor (собственные опубликованные данные компании), paper (опубликованное исследование).
- Google Trends Help, «FAQ about Google Trends data». https://support.google.com/trends/answer/4365533 Официальный источник.
- Daniel Waisberg, «A deep dive into Search Console performance data filtering and limits», Google Search Central Blog (19 октября 2022). https://developers.google.com/search/blog/2022/10/performance-data-deep-dive Официальный источник.
- Pandu Nayak, «Understanding searches better than ever before», The Keyword, Google (25 октября 2019). https://blog.google/products/search/search-language-understanding-bert/ Официальный источник.
- Derek Ruths, Jürgen Pfeffer, «Social media for large studies of behavior», Science 346 (6213), 1063–1064 (28 ноября 2014). https://doi.org/10.1126/science.346.6213.1063 Научная статья, прочитана полностью.
- X Developer Platform, «Search posts» (recent search and full-archive search). https://docs.x.com/x-api/posts/search/introduction Официальный источник.
- Ahrefs, «Long-tail keywords» (статья обновлена 27 мая 2026). https://ahrefs.com/blog/long-tail-keywords/ Данные вендора; методика не публична.
- Google Ads Help, «Low search volume: Definition». https://support.google.com/google-ads/answer/2616014 Официальный источник.
- Search Console Help, «Performance report (Search results): Overview and basic setup». https://support.google.com/webmasters/answer/7576553 Официальный источник.











